LiquidAI 发布 LFM3:2B 级文本到 omni/决策共用骨干
Liquid AI 在 Hugging Face Blog 介绍 LFM3:在约 2B 参数量级把文本、视觉、音频、omni 与决策模型放到同一骨干上,强调单卡微调与端侧部署。厂商称 LFM3-1.7B 以少约 35% 参数优于 LFM2.5-2.6B,4-bit 约 1GB、上下文 256K;具体基准与速度数字为 LiquidAI 主张。
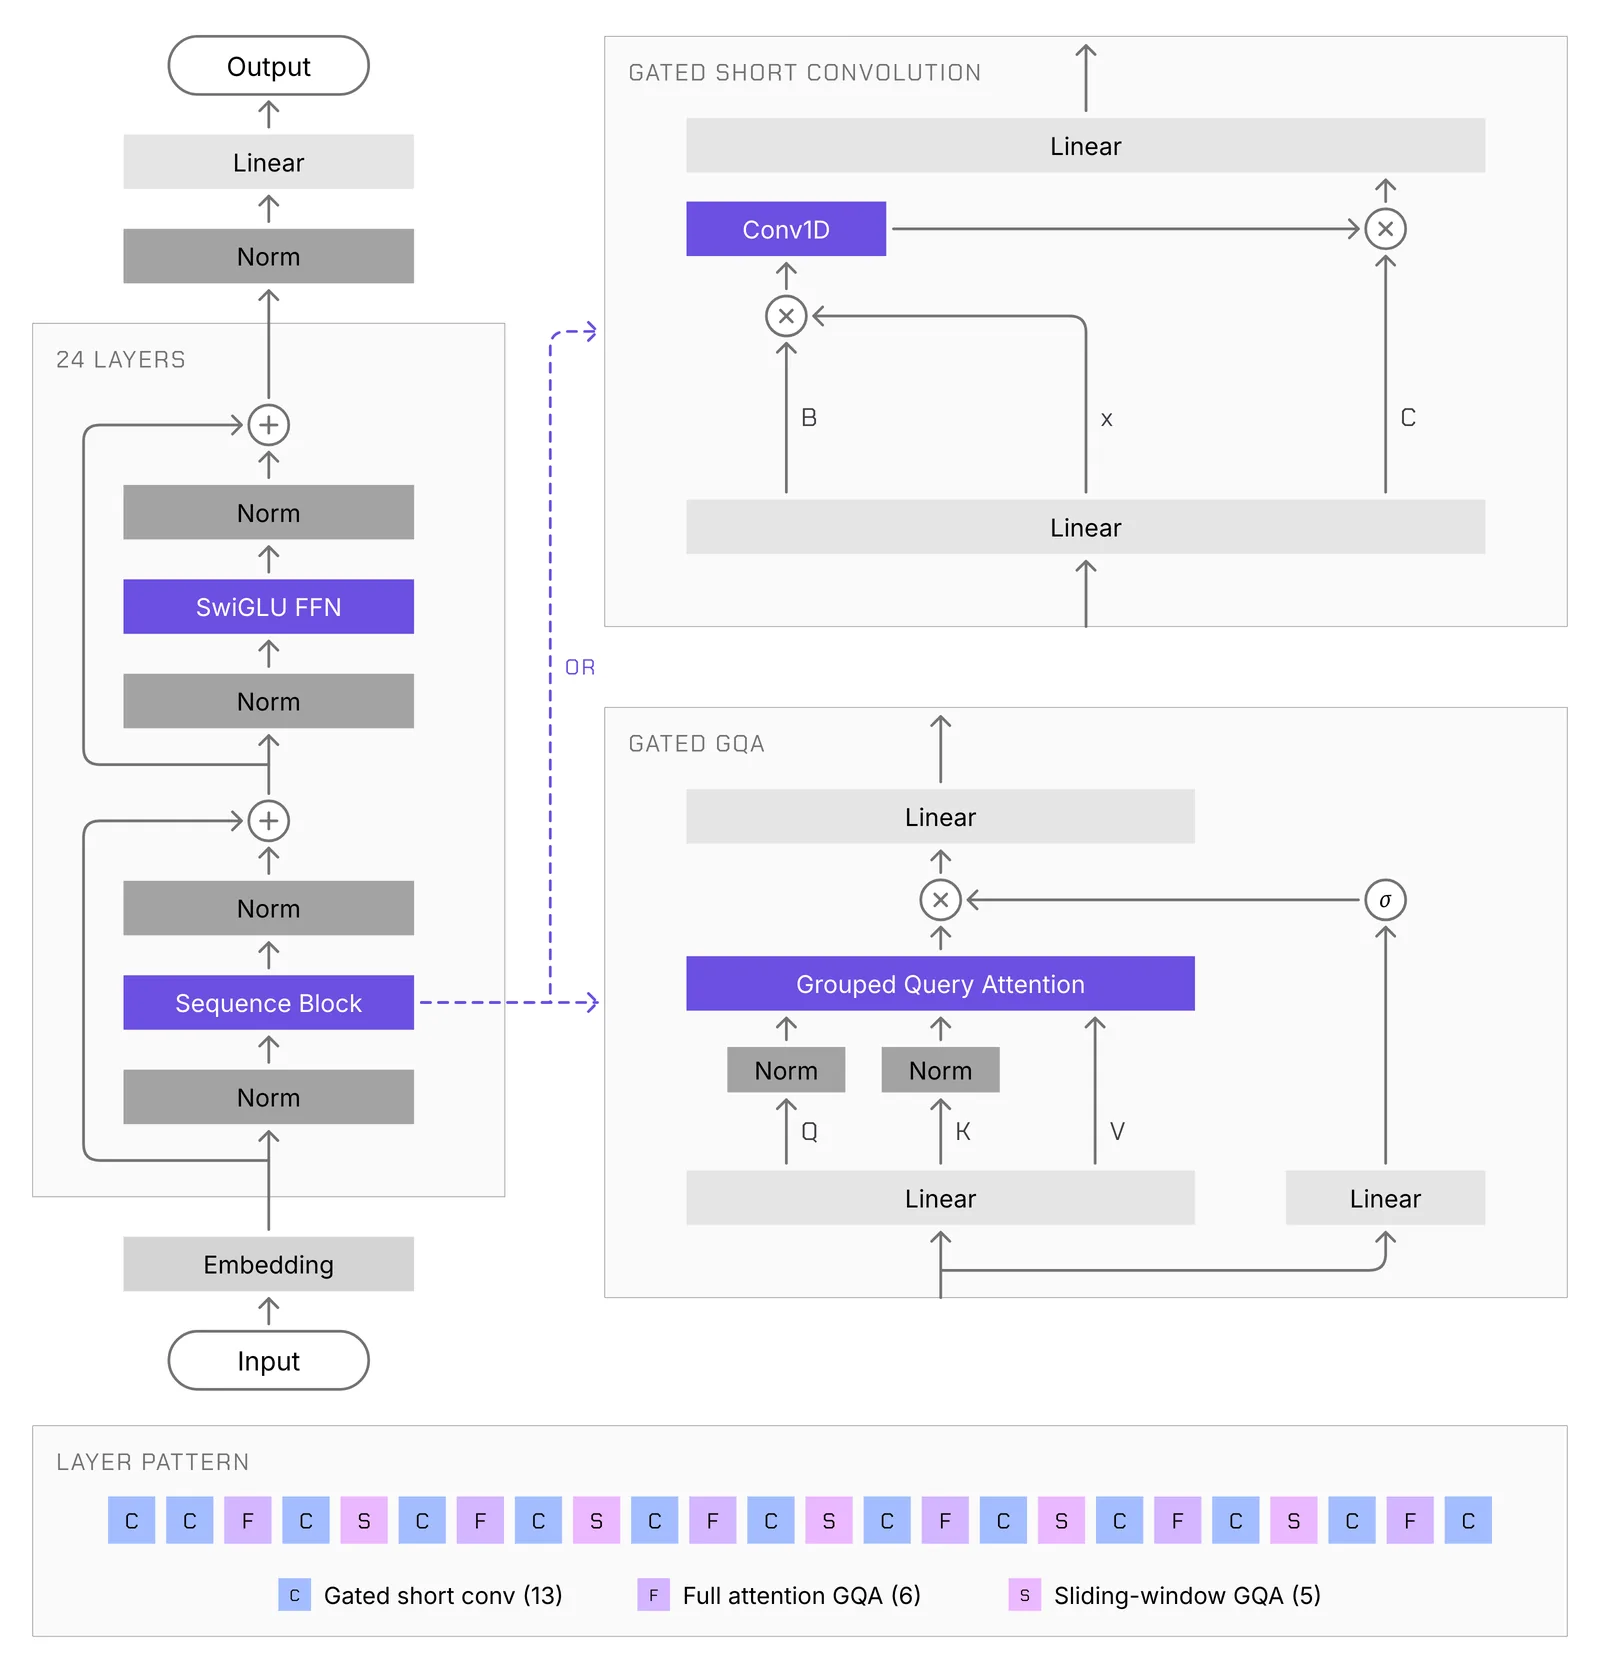
Liquid AI 发布 LFM3(Liquid Foundation Models 新一代),称其为「专用智能」起点:把文本、视觉、音频、omni 与决策模型放到同一骨干,均在约 2B 参数量级,可按模态选型、在单卡上微调并部署到应用侧。相对 LFM2,官方列出四点:单位参数能力更高(称 LFM3-1.7B 以少 35% 参数优于 LFM2.5-2.6B);六款 2B 级模型均自 LFM3-1.7B-Base 分出,含首个 omni 与视觉模型的视频输入;面向边缘(文本 4-bit 约 1GB、自研视觉/音频编码器、文本 256K 上下文);均可单卡微调做专项化。
骨干 LFM3-1.7B-Base 为 24 层 tri-hybrid:13 个门控短卷积、5 个 256-token 滑动窗口注意力、6 个全局注意力,并含 head-wise gated attention、Partial RoPE、Sandwich norm 等(厂商描述)。预训练称 22T token,中段 3.5T 提高智能体轨迹与工具调用占比并把上下文扩到 256K。产品线包括 LFM3-1.7B、LFM3-VL-2B、LFM3-Audio-2B、LFM3-Omni-2B 以及决策模型 d1-2B / d1-omni-2B。厂商给出 WebArena-Verified 等对比分与编码器 FLOPs/首 token 时延等数字——均为 LiquidAI 主张,非本站复测。推理示例基于 transformers,模型卡列其他引擎。
来源
- Build specialized multimodal models with LFM3 — Liquid AI (Hugging Face Blog)