Liquid AI 一周内从 d1 API 走向开放权重,结构化判断有了本地路径
Liquid AI 10 月 5 日介绍 d1 决策 API,随后开放 d1-3B 与实验性 d1-omni-600M 权重。工单分流、分类等固定答案任务可选择托管调用或本地部署,但语音和性能结论仍有明确限制。
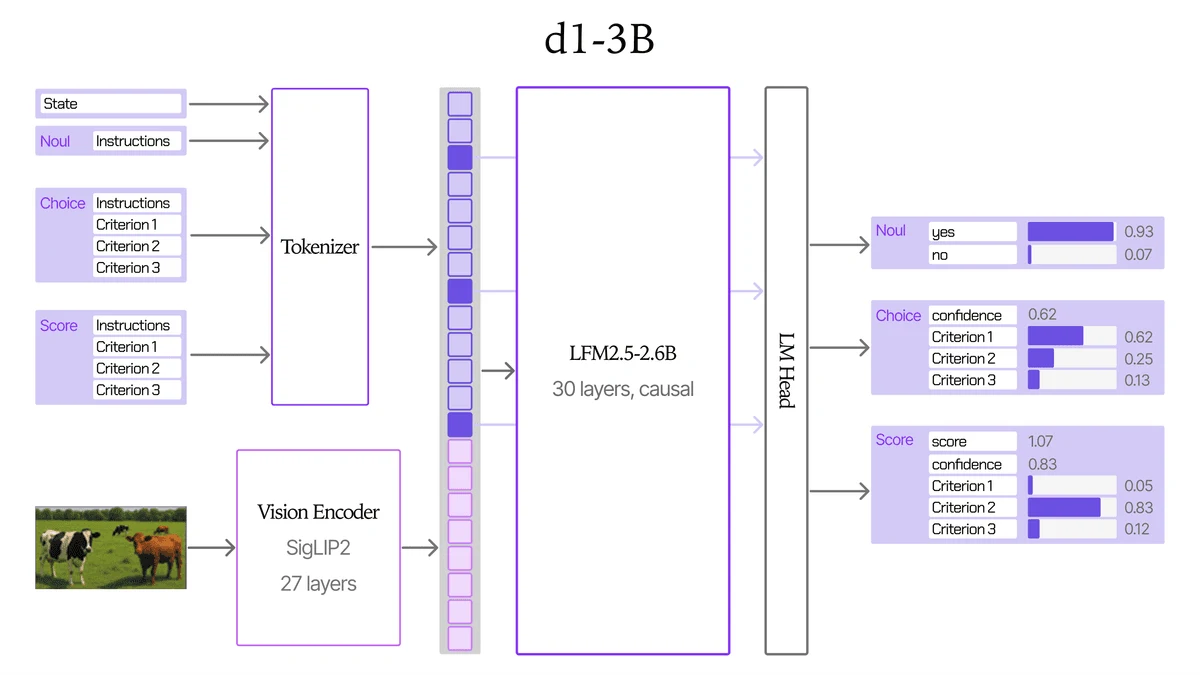
这类模型把输入材料和预设问题读一遍,直接返回是/否、选项或评分等结构化答案,输出 token 数为零,不负责聊天或撰写文字。Liquid AI 列出的用途包括工单分流、内容审核、意图分类、智能体防护和视觉检查,适合答案本来就能由选项或分数表达的环节。
10 月 5 日的 API 介绍说明,d1 只按输入 token 计费,不收输出 token 费用;每个问题按独立提示计费。图片与文字同价计入输入,每个 32×32 像素块为1.5 token,1024×1024 图片约为1,536 token。该文的成本比较按每百万输入 token 0.04 美元计算,是厂商对每项应用、每个模型各运行一次的比较,不能据此保证任何工作流都能获得同样节省。Vercel 和 OpenRouter 当时提供文字入口,视觉能力尚待上线。
d1-3B 基于 LFM2.5-VL-3B,实际为 3.12B 参数,支持文字与图片,上下文为 32,768 token。较小的 d1-omni-600M 实际为 587M 参数,增加语音路径,总上下文为 16,384 个文字、图片和音频位置;带图片时,情境与问题的文字会截至 896 token。
d1-omni-600M 仍是实验性早期研究版本。一次请求可携带图片或音频,不能同时包含两者;语音片段最多30秒,训练内容来自英语说话者与助手之间的请求,不能据此推定中文等其他语言的语音表现。Liquid AI 尚未公布这个小版本的推理速度。
Liquid AI 自测称,d1-3B 在 Decision Index 0.2.1 公共部分得分 48.57,高于对照中的 Decider 35B-A3B 的 47.11;d1-omni-600M 为 15.95。模型卡说明,d1 的分数由公司使用官方评分器计算,并非排行榜提交结果,其余模型取自公开榜单。这些是特定决策任务上的厂商评测,不是通用聊天能力排名。
速度数字也有具体条件。公司在预热后、一次处理一个请求的单问题测试中,报告 d1-3B 在 RTX 4090 上耗时8毫秒;GPU 测试使用 bf16,取20次运行的中位数,RTX 4090 还启用了 CUDA graphs 优化,不启用时为16毫秒。Jetson AGX Thor、AGX Orin 和 Orin Nano 的单问题结果分别为16、26和50毫秒。这不能泛化为任意图片、长输入、并发负载或 d1-omni-600M 的延迟。
两个模型的权重均已放在 Hugging Face,可下载本地运行,另有官方网页演示。模型卡的 Transformers 路径要求 d1-3B 使用 5.14 或以上版本、d1-omni-600M 使用 5.15 或以上版本,且需要允许加载仓库自带代码。
来源
- Multimodal open d1 decision models for the edge — Liquid AI
- Open d1: Edge decision models for text, vision, and audio — Liquid AI 模型与工程博客(网页)
- LiquidAI/d1-3B · Hugging Face — Liquid AI
- LiquidAI/d1-omni-600M · Hugging Face — Liquid AI
- Introducing d1: The most capable decision model, now with vision — Liquid AI 模型与工程博客(网页)