Liquid AI 发布 LFM2.5-24B-A2B:开放权重、面向本地智能体
Liquid AI 于2026年10月13日发布总参数240亿、每 token 激活约24.5亿参数的推理模型 LFM2.5-24B-A2B,权重可在 Hugging Face 下载,商用有收入门槛。
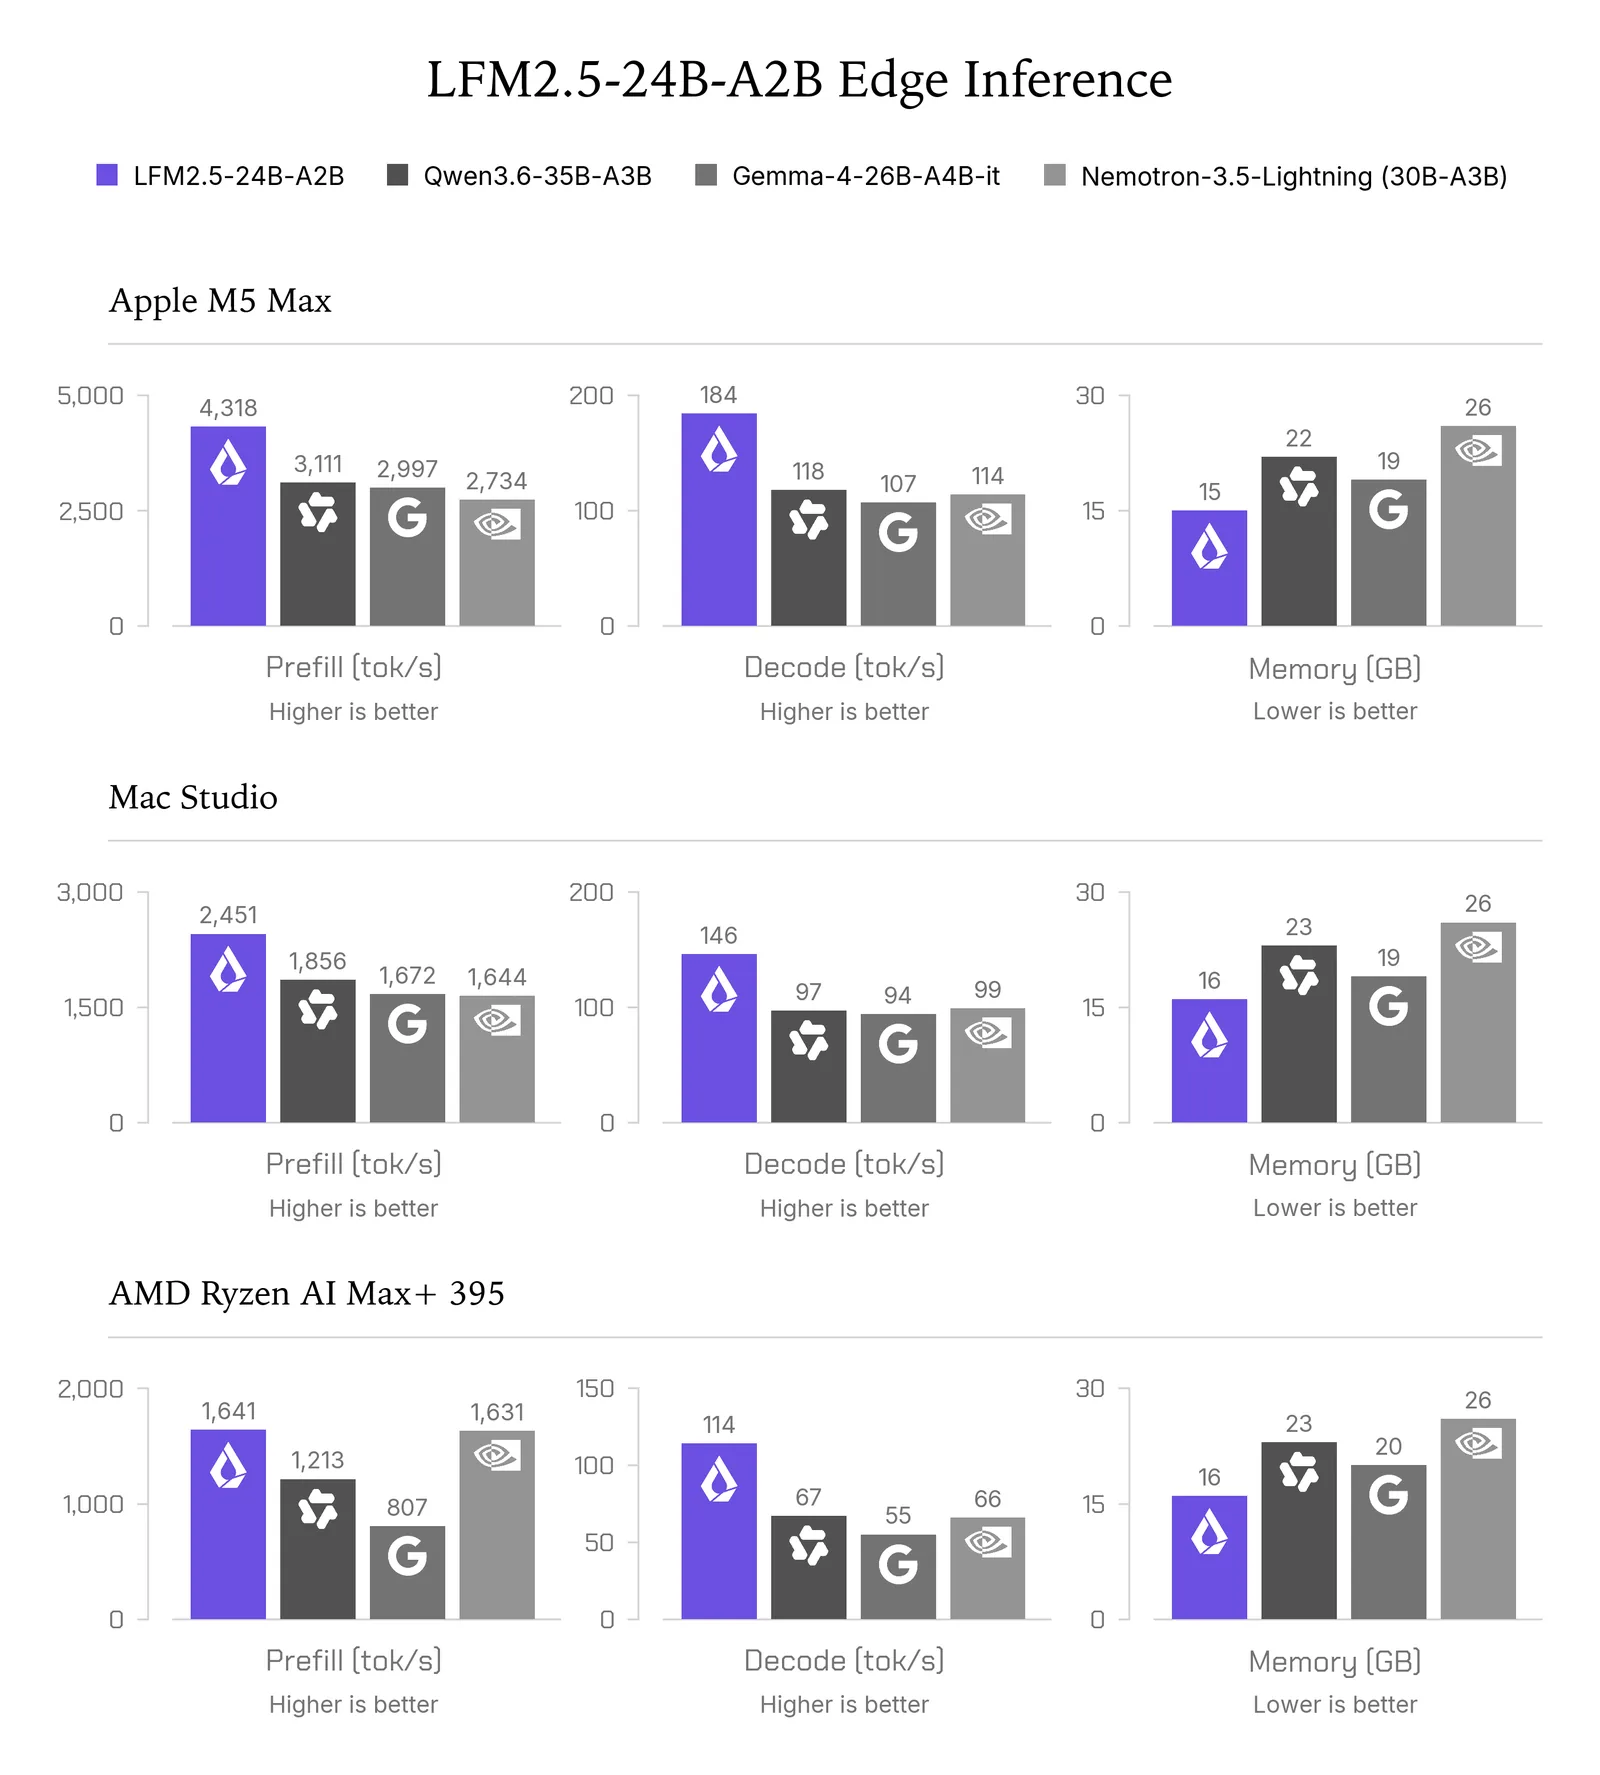
Liquid AI 于2026年10月13日发布 LFM2.5-24B-A2B,并称其为 LFM2.5 系列中最大、也是最后一款模型。基座版和后训练版均以开放权重形式在 Hugging Face 和 Liquid 的 Playground 提供。
据模型卡,这是一款纯文本推理模型,总参数240亿,激活参数24.5亿,上下文长度131,072 token,支持包括中文在内的16种语言。与上一代 LFM2-24B-A2B 不同,它总是先推理再作答。Liquid 建议将其用于需要推理、调用工具并在本地运行的智能体;不建议单独用于知识密集型任务,应配合检索或网页搜索。
Liquid 称,在8项智能体与工具调用基准中的5项上,它可与总参数和激活参数都多约50%的 Qwen3.6-35B-A3B 竞争,例如 LiveClaw 得分48.09对38.19。速度方面,公司报告在 Apple M5 Max 上解码每秒184 token;在单张 NVIDIA B300 上,用 SGLang 0.5.22、BF16、1,024 token 输入、最多256 token 输出的持续并发负载下,合计输出超过每秒2.1万 token。这些均为厂商测量,后者是并发总吞吐而非单用户速度。
提供 GGUF(llama.cpp)、MLX、FP8、ONNX 等格式;用于 SGLang 推测解码的 DSpark 草稿模型标注为“即将推出”。经 Liquid 自有 API 使用时,价格为每百万输入 token 0.10美元(缓存输入0.05美元)、每百万输出 token 1美元,新注册用户可获2美元额度。
权重采用 LFM Open License v1.0,以 Apache 2.0 为基础,但增加商业使用限制:许可正文将门槛定义为年收入1,000万美元或以上,达到门槛的公司须另购商业许可;合格非营利机构用于非商业或研究目的不受收入门槛限制。
来源
- LFM2.5-24B-A2B (Liquid AI blog) — Liquid AI
- LiquidAI/LFM2.5-24B-A2B model card — Liquid AI (Hugging Face)
- LFM Open License v1.0 — Liquid AI