Microsoft ThinkingBox 用数据库结果检查 AI 智能体:一次做对,不等于稳定可靠
Microsoft 与 Hugging Face 介绍了包含 507 项业务任务的开放评测环境,每项重复运行 20 次,核对最终记录和多余操作。它区分“偶尔成功”和“连续成功”,可供开发者复测自己的智能体。
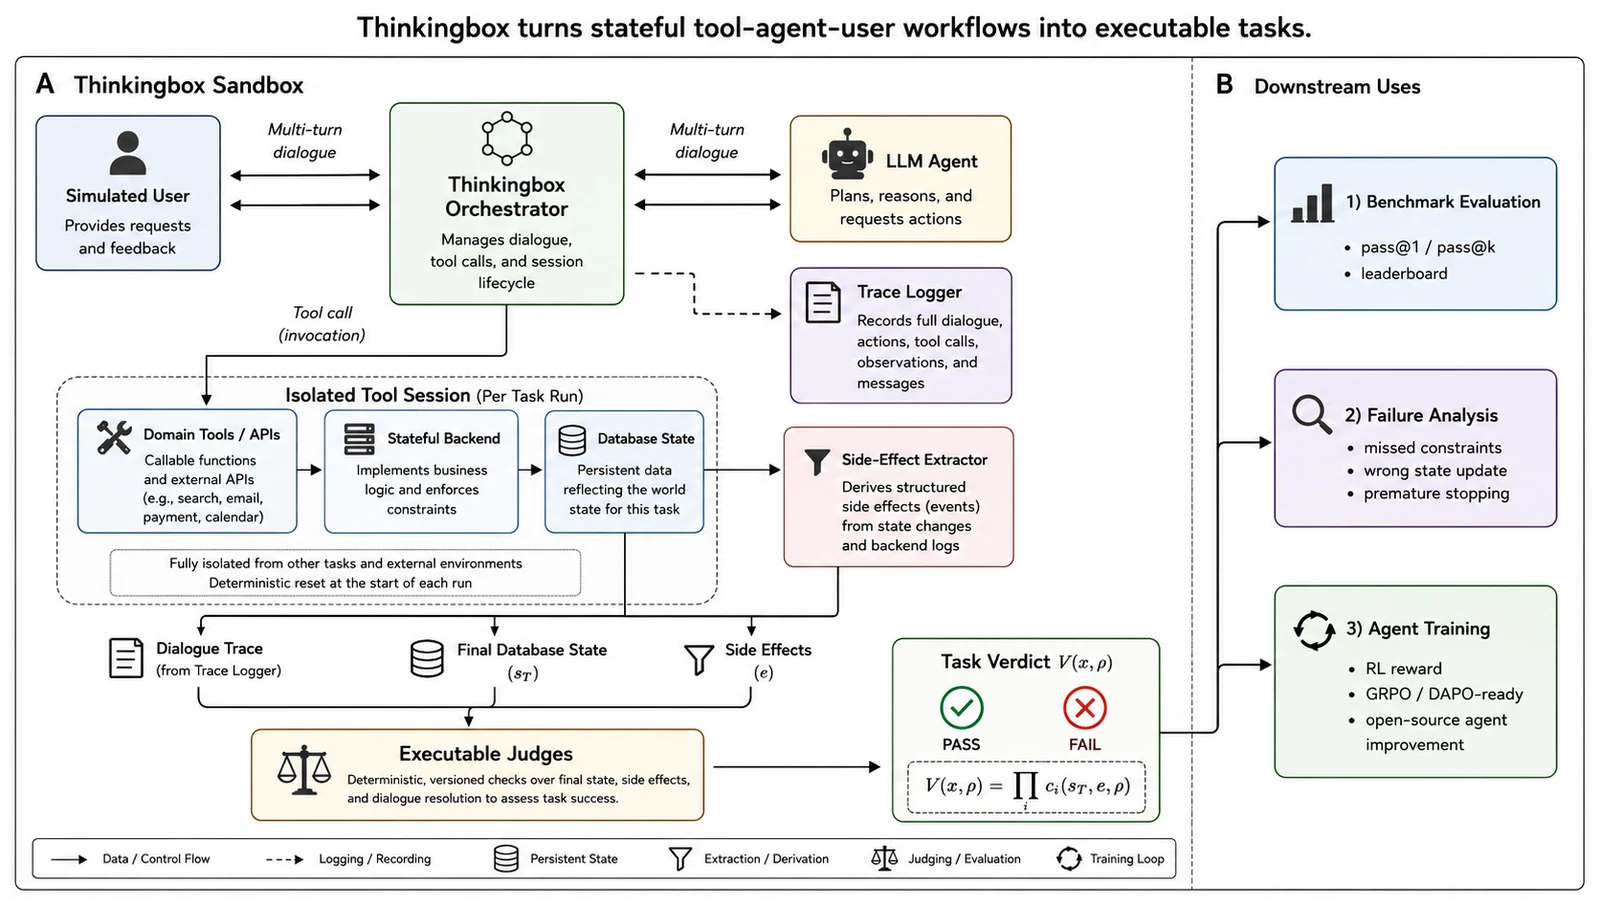
Microsoft 与 Hugging Face 在 10 月 3 日发布联合博客,介绍已通过 Hugging Face 提供的 ThinkingBox;其发布时间对应上海 10 月 4 日。它让 AI 智能体在隔离的工具环境中处理业务任务,再检查数据库最终状态和实际副作用。示例中,一个智能体虽然完成了多次工具调用,却把仍待处理的物流工单关闭为“已解决”,说明看似完整的操作过程可能留下错误结果。
ThinkingBox-Bench 包含零售、车险、旅行、数字银行和咨询领域的 507 项任务,每项从相同的干净状态独立运行 20 次。单次尝试成功比例、20 次中至少成功一次的任务比例,以及 20 次全部成功的任务比例,回答的是不同问题。研究报告中,Kimi-K3 至少成功一次的任务比例为 93.89%,但全部 20 次通过的比例为 13.41%;这些是在该基准条件下的结果,不能直接当作实际业务的成功率。
框架与基准已开放,开发者可以使用自己的模型重复运行。公开任务是对企业工作流的合成重建,并非真实客户记录。它让团队能检查智能体究竟改对了哪些记录、是否多做了不该做的操作,以及同一任务重复执行时是否仍然可靠;本站未独立重跑该评测。
来源
- The Agent Said It Was Done. The Database Disagreed. — Microsoft / Hugging Face
- microsoft/thinkingbox — Microsoft / GitHub