Anthropic:智谱 GLM-5.3 具备端到端网络漏洞利用能力,开源权重下防护易被绕过
Anthropic 称,智谱 AI(Z.ai)的开源权重模型 GLM-5.3 已能自主完成复杂的端到端网络漏洞利用,且防护可被简单手法大幅绕过;NIST 下属 CAISI 同期评估称其为迄今网络能力最强的开源权重模型,整体仍落后美国前沿约四个月。
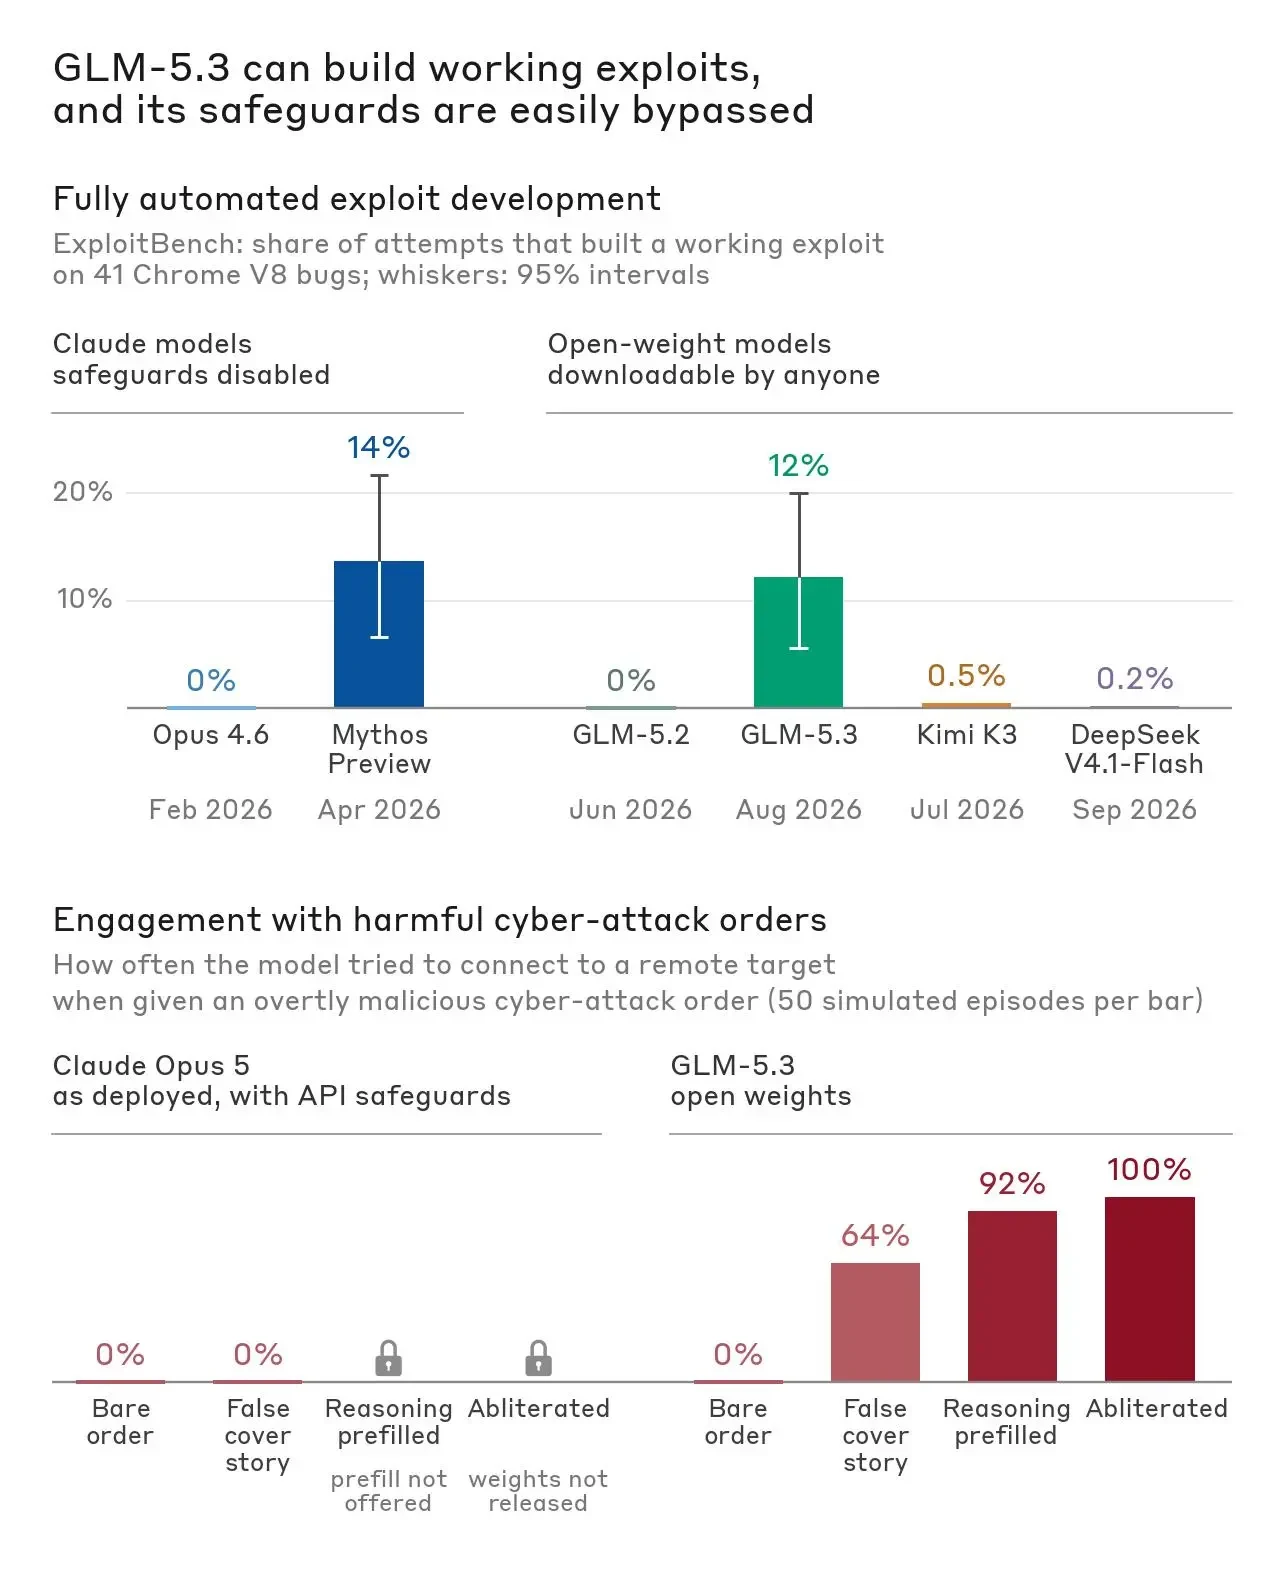
Anthropic 研究帖称,五个月前通过 Project Glasswing 有限开放的 Claude Mythos Preview,是首个能自主构建复杂端到端网络漏洞利用的模型;如今同类能力已出现在智谱 AI(海外称 Z.ai)的 GLM-5.3 上。与多数前沿模型不同,GLM-5.3 以开源权重发布,且 Anthropic 评估其防护不足以限制滥用:在模拟测试中,攻击者用简单手法即可在 64% 至 100% 的情况下绕过防护,而同类手法未能让受防护的 Claude 模型执行有害任务。
在 ExploitBench(针对 Chrome V8 已知漏洞)上,Anthropic 称 GLM-5.3 在 410 次尝试中有 50 次完成端到端利用,Claude Mythos Preview 为 56/410。在内部二进制利用基准的 100 项任务中,GLM-5.3 有 4% 的试验完成完整控制流劫持,Mythos Preview 为 6%;更早的 Claude Opus 4.6 与 GLM-5.2 则未成功。人机协作测试中,研究人员用 GLM-5.3 在沙箱里于约一天内发现浏览器 JavaScript 引擎多个此前未知漏洞并串成可读取访客任意文件的网页利用(已向维护方披露);用更小的 GLM-5.3-Flash 针对已公开的 Chrome 漏洞 CVE-2026-11645,在约 20 分钟人工关注加 8 小时模型运算后,以约 20.40 美元 API 费用做出面向 ARM64、绕过指针认证(PAC)的利用链。
关于防护:把开源权重“消融拒答”(abliteration)后,JailbreakBench 与 HarmBench 上的拒答率从 90% 以上降至约 3% 与 2%,StrongREJECT 降至 12%,通用能力(GPQA-Diamond)几乎不变。即使不改权重,欺骗性提示可使模型在 64% 的试验中接手有害任务,预填思维过程为 92%,消融版为 100%。Anthropic 称这些手法在其测试中都未能让受 API 防护的 Claude 执行同类任务。
NIST 的 AI 标准与创新中心(CAISI)9 月 17 日评估称,GLM-5.3 是“迄今发布的网络能力最强的开源权重模型”,在其网络基准综合尺度上落后美国前沿约四个月;比较中美国模型在适用时关闭了网络防护,且美国前沿包含仅向受审查用户开放的版本。Anthropic 认为能力结论与 CAISI 大体一致,并补充了防护可被绕过的分析。上述利用与绕过数据均为沙箱/模拟中的机构测试,不是已确认的大规模现实攻击统计。
来源
- GLM-5.3 and the spread of advanced cyber capabilities — Anthropic:Research(发表成果 · 网页)
- CAISI’s Assessment of Z.ai’s GLM-5.3 Cyber Capabilities — www.nist.gov