Claude Haiku 5.5 降低短提示词单价,长上下文采用五倍价格
Anthropic 已推出 Claude Haiku 5.5,首次为 Haiku 系列加入可调推理强度和自适应思考,面向摘要、分类等高频任务。独立评测显示能力明显提升,但最高强度的输出量较大,实际任务成本仍取决于提示词长度和推理设置。
短提示词的 API 单价显著下调,但有明确分档:提示词不超过 100k token 时,每百万输入/输出 token 分别为 0.10/0.50 美元;超过 100k 后升至 0.50/2.50 美元,是低档的五倍。缓存读取每百万 token 分别为 0.01/0.05 美元,五分钟缓存写入为 0.125/0.625 美元,均按同一提示词长度门槛区分。
Haiku 5.5 支持文字和图片输入、文字输出,上下文窗口从前代的 200k 扩至 100 万 token。Anthropic 将其定位于摘要、上下文压缩、数据库查询、分类和编程子智能体等范围较窄的高频任务;复杂的多步编程仍更适合 Sonnet 5.5 或 Opus 5.5。公司称模型已在 Claude Platform、Amazon Web Services、Google Cloud 和 Microsoft Azure 提供,Claude Platform 的模型标识为 claude-haiku-5-5。
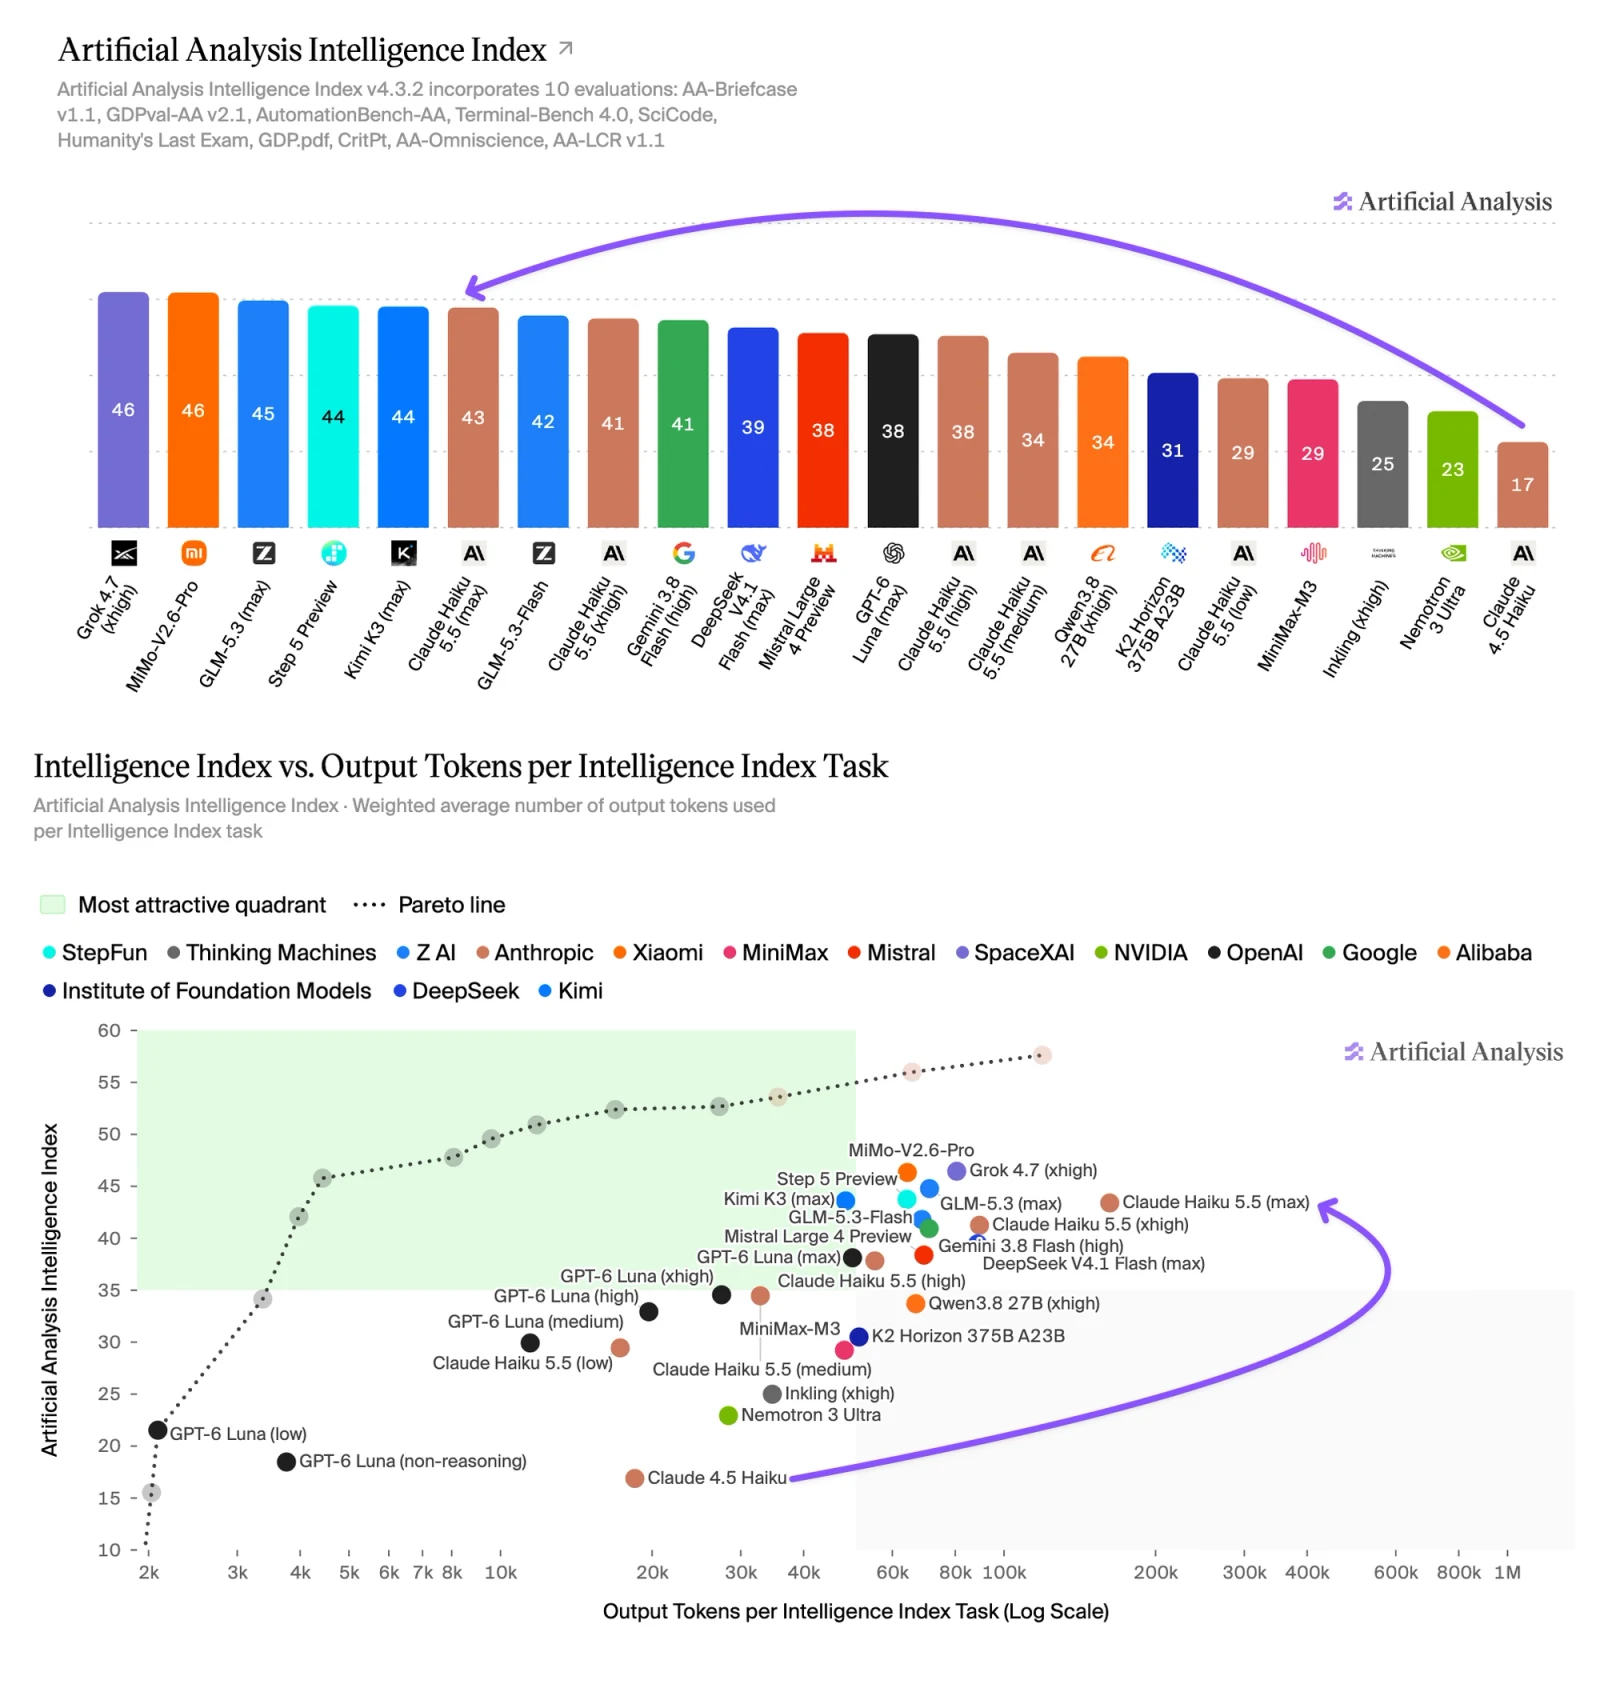
Artificial Analysis 在10月7日发布的独立评测中,将最高推理强度 max 档的 Haiku 5.5 智力指数评为 43,比上一代高 26 分,但低于 Sonnet 5.5 的 max 档 56 分。Haiku 5.5 在 Terminal-Bench 4.0 命令行任务评测中得分 33%,前代为 0%;这些测试支持它的能力有所提升,并不表示小模型已经全面替代更大的模型。
最高强度的代价是更多输出:Haiku 5.5 的 max 档在每项智力指数任务中平均使用约 162k 输出 token,约为 GPT-6 Luna max 档约 50k 的三倍;从 xhigh 升至 max,仅多得 2 分,输出量却约增至 1.8 倍。Artificial Analysis 也说明,其暂定成本数字尚未计入超过 100k 提示词后的价格跃升。因此,不能把较低的 token 单价直接当成每项任务都会按同比例省钱。
能力也不均衡。Artificial Analysis 的事实知识测试 AA-Omniscience 中,Haiku 5.5 的准确率为 36%;评测方称,它较愿意承认不知道,幻觉率低于文中比较的 Gemini 3.8 Flash 和 GPT-6 Luna。在 AutomationBench-AA 中它得到 35%,评测方认为发布前测试中的过度拒答拖累了结果,并称 Anthropic 正在处理,后续将重测;这不是已经修复后的成绩。
同一份官方公告还公布 Sonnet 5.5 缓存读取降价,每百万 token 从 0.20 美元降至 0.10 美元。Anthropic 估计,这可使多数智能体任务的成本降低约 20%,实际幅度取决于缓存用量。
公告另预告向 Max 和 Team 订阅者提供每月 Claude Platform API 额度,可用于任一模型:Max 5x 为 100 美元,Max 20x 为 200 美元,Team 为团队成员共用、最高 500 美元。公告只用“本周”描述推出安排,未注明可确认的日历日期,因此这些额度仍应视为宣布的计划,不能假定所有账户已经到账。
来源
- Anthropic has released Claude Haiku 5.5 — Artificial Analysis 完整文章(网页)
- Introducing Claude Haiku 5.5 — Anthropic:Newsroom(网页)