英伟达开源 Nemotron 3.5 Transcribe:转写、翻译与说话人识别合一
NVIDIA 在 Hugging Face 发布开源权重的 Nemotron 3.5 Transcribe(约 34B 总参、约 4.3B 激活),面向离线录音:官方称支持 40 种语言转写、最长约 1 小时,并可用文本指令切换逐字/书面语/说话人归属/翻译等输出。许可为 OpenMDW-1.1,声明可商用或非商用;不支持实时流式。
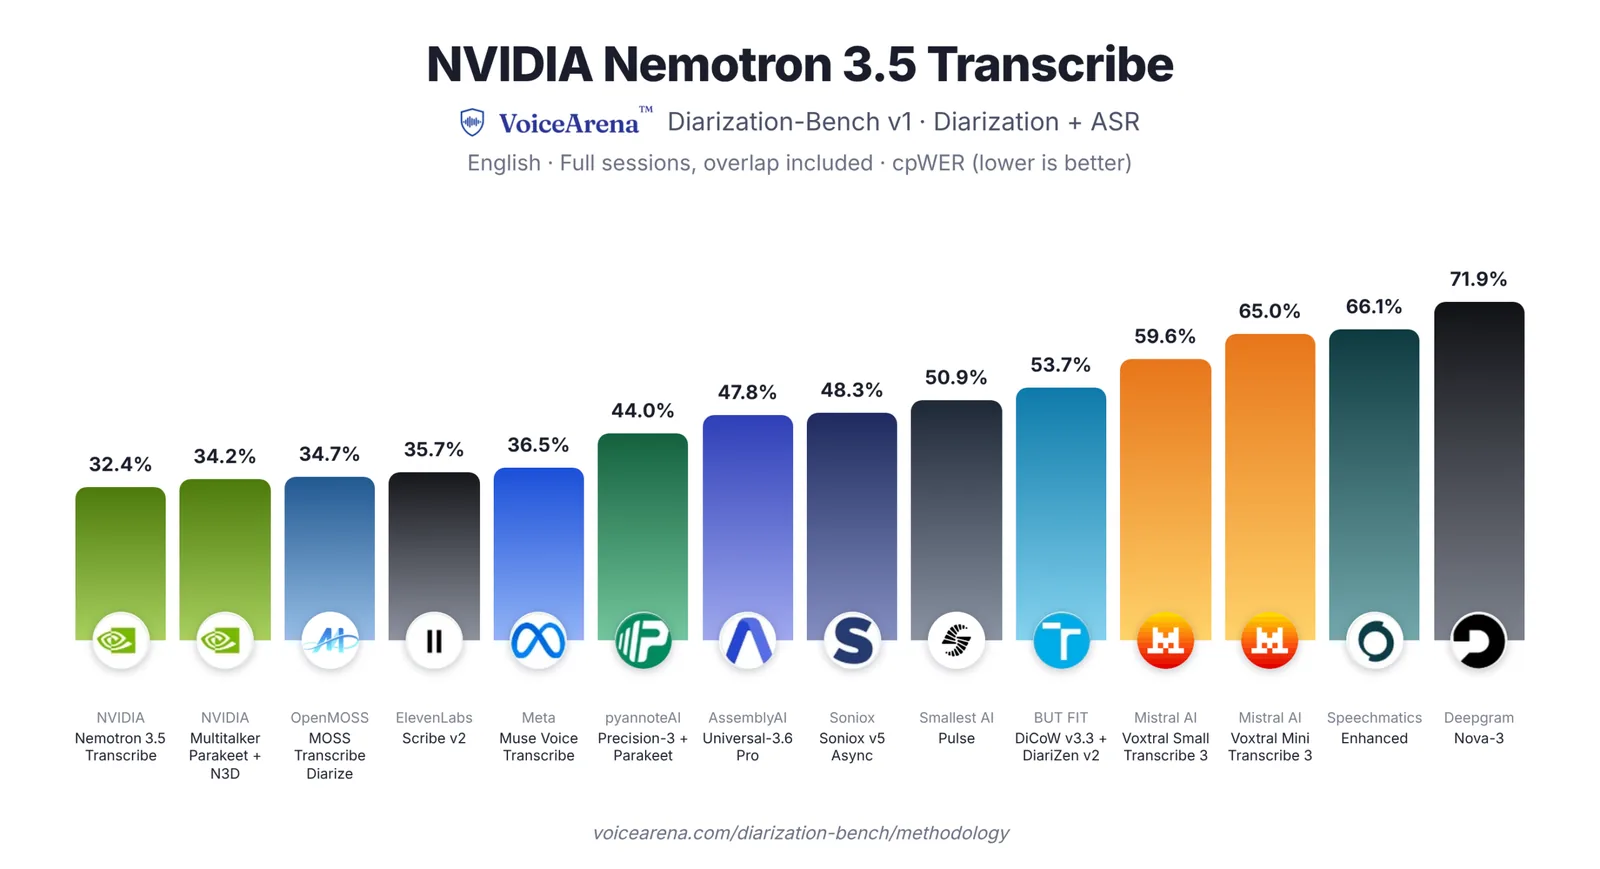
NVIDIA 经 Hugging Face 发布 NVIDIA-Nemotron-3.5-Transcribe-30B-A4B。模型卡称其为开源权重的离线语音与音频模型:混合 MoE(Mamba-2–Transformer)加并行专家编码器,总参数约 34B(含音频编码器),每步激活约 4.3B;上下文 65,536 token,录音最长约 1 小时;精度提供 BF16,并有 FP8 与 NVFP4 变体。任务覆盖逐字或书面语转写、上下文转写、说话人归属、富文本转写、语音翻译、语种识别与音频问答等。许可 OpenMDW-1.1,卡上写明 ready for commercial or non-commercial use。
能力细节上,The Decoder 综述称该模型转写 40 种语言、可在 31 种语言与英语之间翻译,并在 13 种语言上识别说话人,单段最长约 1 小时、最多约 8 名说话人;用户用自然语言指令控制输出形态,也可传入术语提示。效率方面,Decoder 转述称在 RTX PRO 6000 Blackwell Server Edition、NVFP4 下处理 100 小时音频不到三分钟;模型卡则给出 NIM/NVFP4 下可达约 2,238× 实时等厂商效率数字。卡上 Results at a Glance 标注评测快照日为 2026-10-12,含 Open ASR Leaderboard 等自报错误率,需按基准条件理解。
数据与限制:Decoder 称同步开源 Granary v2 数据集(约 84.4 万小时、48 语,多种转写风格)。模型卡与 Decoder 均强调其为离线(非实时)模型;功能因语言而异,音频问答等训练侧重英语;建议对姓名、说话人切换与问答结果做抽查。权重与数据集在 Hugging Face,另有演示与微调指南。此前 Nemotron 3 Diarization 需搭配独立 ASR;本模型合并转写与说话人等任务,但不做实时处理。
来源
- nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B — NVIDIA (Hugging Face)
- Nvidia's open Nemotron 3.5 Transcribe combines transcription, translation, and speaker recognition — The Decoder