AI 水印核验扩大入口,但“未检出”仍不能证明是真人内容
Google 的 SynthID 媒体核验网站扩大到公众使用;OpenAI 公布面向欧盟 ChatGPT 与 Codex 的文本水印计划。两者的内容类型、开放对象与推出阶段不同,也都不能把水印当成事实核查结论。
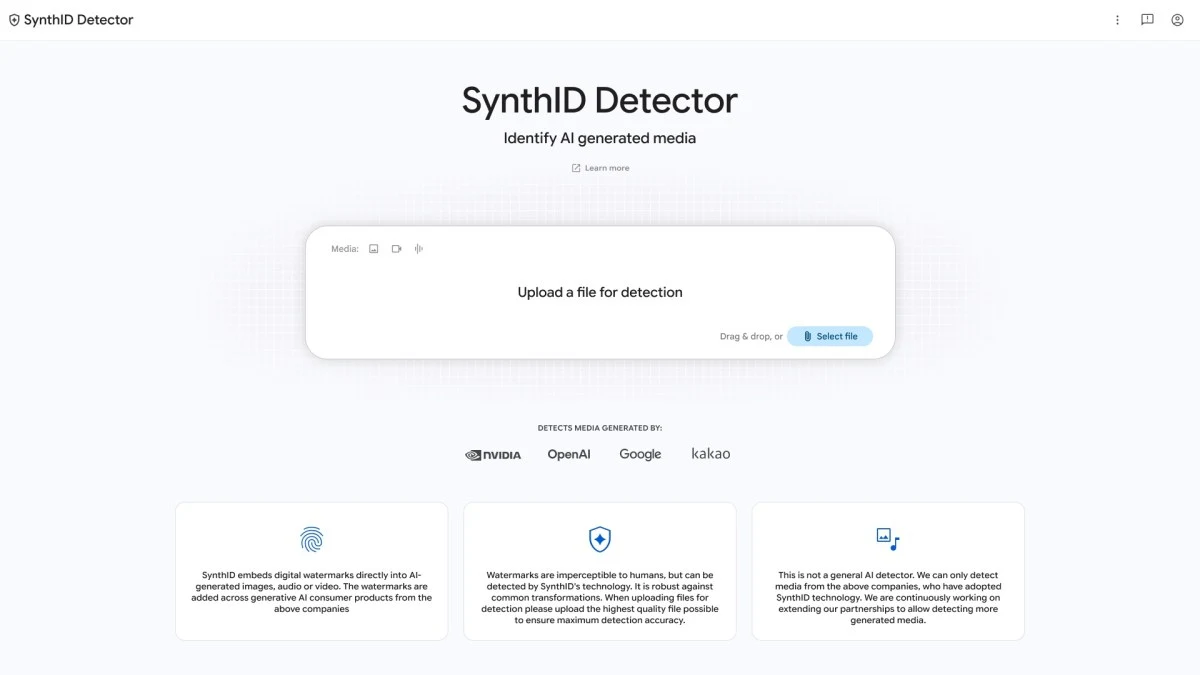
据 TechCrunch 报道,Google 本周向公众开放 SynthID Detector 网站,让用户上传图片、视频或音频检查相应水印;此前只向部分记者、媒体从业者和研究人员测试开放。它识别的是 SynthID 标记,不能覆盖所有 AI 系统生成的内容。
OpenAI 于 10 月 5 日公布 textGrain 文本水印方案:全球 API 客户可为部分模型选择启用,默认关闭;欧盟符合条件的 ChatGPT 与 Codex 文本输出将在未来数周加入不可见水印,尚非全球默认。检测器初期仅向获准研究者和专业机构开放。方案回应欧盟 AI 法案对服务提供者的机器可读标记要求;水印通过用词中的统计信号判断文本是否带有 OpenAI 标记。
OpenAI 自报的英语 ELI5 测试显示,目标误报率为 1% 时,心理学类 200-token 文本检出率约 80%,400-token 约 95%;数学文本更低。400-token 文本替换 10% 词语后,检出率从约 92% 降至 66%,替换 25% 后为 17%。这些数字不能外推为所有语言或文本的检测效果。水印不能证明准确性、所有权或作者身份;未检出也不能证明由人类创作。
把这两项进展放在一起,能确认的是来源标记和核验入口在扩展,不能确认的是所有生成内容都能被识别。媒体核验需要匹配水印,文本核验还受长度、题材和改写影响;有无水印都不能代替核对原始出处和内容本身。
来源
- Our approach to EU text provenance rules — OpenAI
- Code of Practice on Transparency of AI-generated Content — European Commission
- Google’s new SynthID website can identify AI-generated media — TechCrunch