Inception 发布 Mercury 3:称对标 Luna/Haiku,约 1068 tok/s
Inception Labs 发布扩散式大模型 Mercury 3,官方称在多项基准上优于或持平 GPT-6 Luna 与 Claude Haiku 5.5,NVIDIA GPU 上输出约 1068 token/秒(相对上述速度优化模型约快 4–8 倍),上下文扩至 1M token,标价每百万 token 输入 0.20 / 输出 0.70 美元,上市期五折为 0.10 / 0.35 美元。
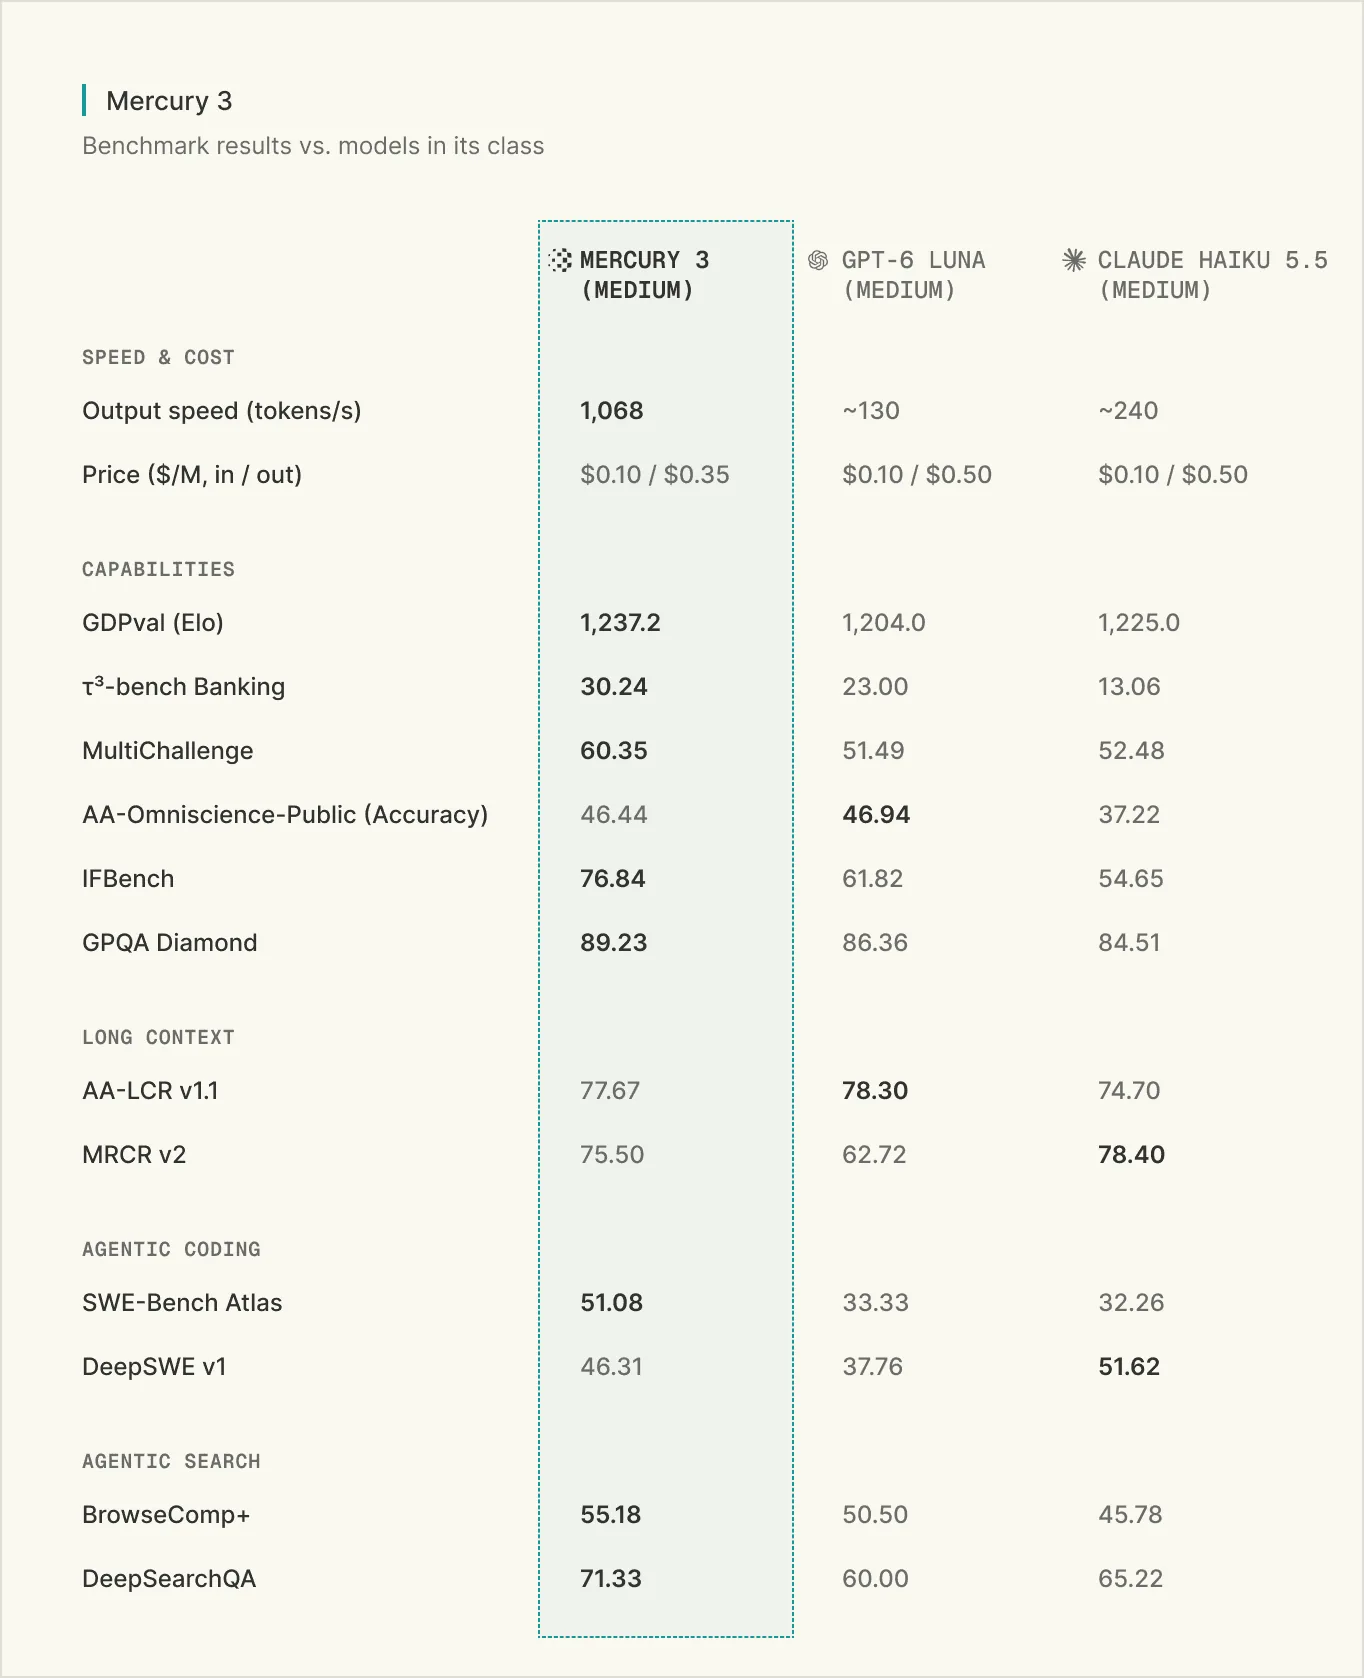
Inception Labs 发文称推出迄今最强的扩散式 LLM Mercury 3。公司概述:质量“与 GPT-6 Luna、Claude Haiku 5.5 等速度优化前沿模型相当或更好”;速度在 NVIDIA GPU 上为 1,068 tokens/秒;上下文窗口 1M tokens(相对 Mercury 2.5 的 260K);标价为每百万 token 输入 0.20 美元、输出 0.70 美元,上市期五折为输入 0.10、输出 0.35,缓存 token 相对输入价再减 90%。文中称 Mercury 3 参数规模较 Mercury 1 扩大逾 40 倍,并称标准基准上的“智力”相对 Mercury 1(mini)约提升 3 倍——上述对比均为厂商主张。
官方称 Mercury 3 即日起可在 Inception API Platform 以及 OpenRouter、Baseten、Vercel 使用,兼容 OpenAI API;并提供 1 亿免费 token 试用额度。产品组合还包括面向语音低时延的 Mercury Voice,以及官方称在 JevBench、LegalBench 等上优于 Jev 的决策模型 Mercury Decide。早期合作方用例涵盖浏览器智能体、互动教育、实时搜索与客服;文中引用的 Mind2Web 完成率与眼镜端时延等数字来自合作方或厂商自测。
来源
- Introducing Mercury 3 — Inception Labs