Anthropic 详解智能体记忆:让 Claude 在会话间“做梦”纠错,wiki 并非总比搜索好
Anthropic 11 月 6 日发布工程研究,介绍 Claude 如何在会话间回看日志、纠正错误记忆并整理关联知识。公司内部评测显示,离线整理可提升特定文档任务的表现,但增益取决于任务,维护记忆也要额外计算;这不是 Claude 全产品新增功能的上线公告。
Anthropic 将这里的“智能体记忆”定义为:Claude 从交互和任务中获得、跨会话保留、以后能作为上下文读取的知识。它不包括修改模型权重、单次对话中的上下文学习或对话压缩。所谓 dreaming,是让模型在交互间隙回看日志和转录,检验既有笔记、修正错误,再组织成新的记忆表示;原文也提到 Letta 与加州大学伯克利分校此前提出的 sleep-time compute 思路。
这套设计关注的不只是“存得更多”。在宝可梦实验中,Claude 曾把地标位置记反,之后反复走错路;让它对照原始转录检查笔记后,错误得到纠正,后续路线也改变了。Anthropic 同时发现,较强模型更能判断什么值得记:只机械要求“仅记录失败”,反而会削弱部分模型从记忆获得的收益。
在 Stainless 内部文档实验中,Anthropic 用约 35 万份、约 4.2 亿 token 的文件构建资料库,让 Opus 5 智能体经过 128 轮整理逐步建立互相链接的 wiki。针对 25 个问题,只用 wiki 作答时,满足评分标准的比例随整理规模扩大,从 13% 提升至 48%。这是该公司自评中的特定文档问答结果,不是通用准确率,也不是普通聊天整体提升。
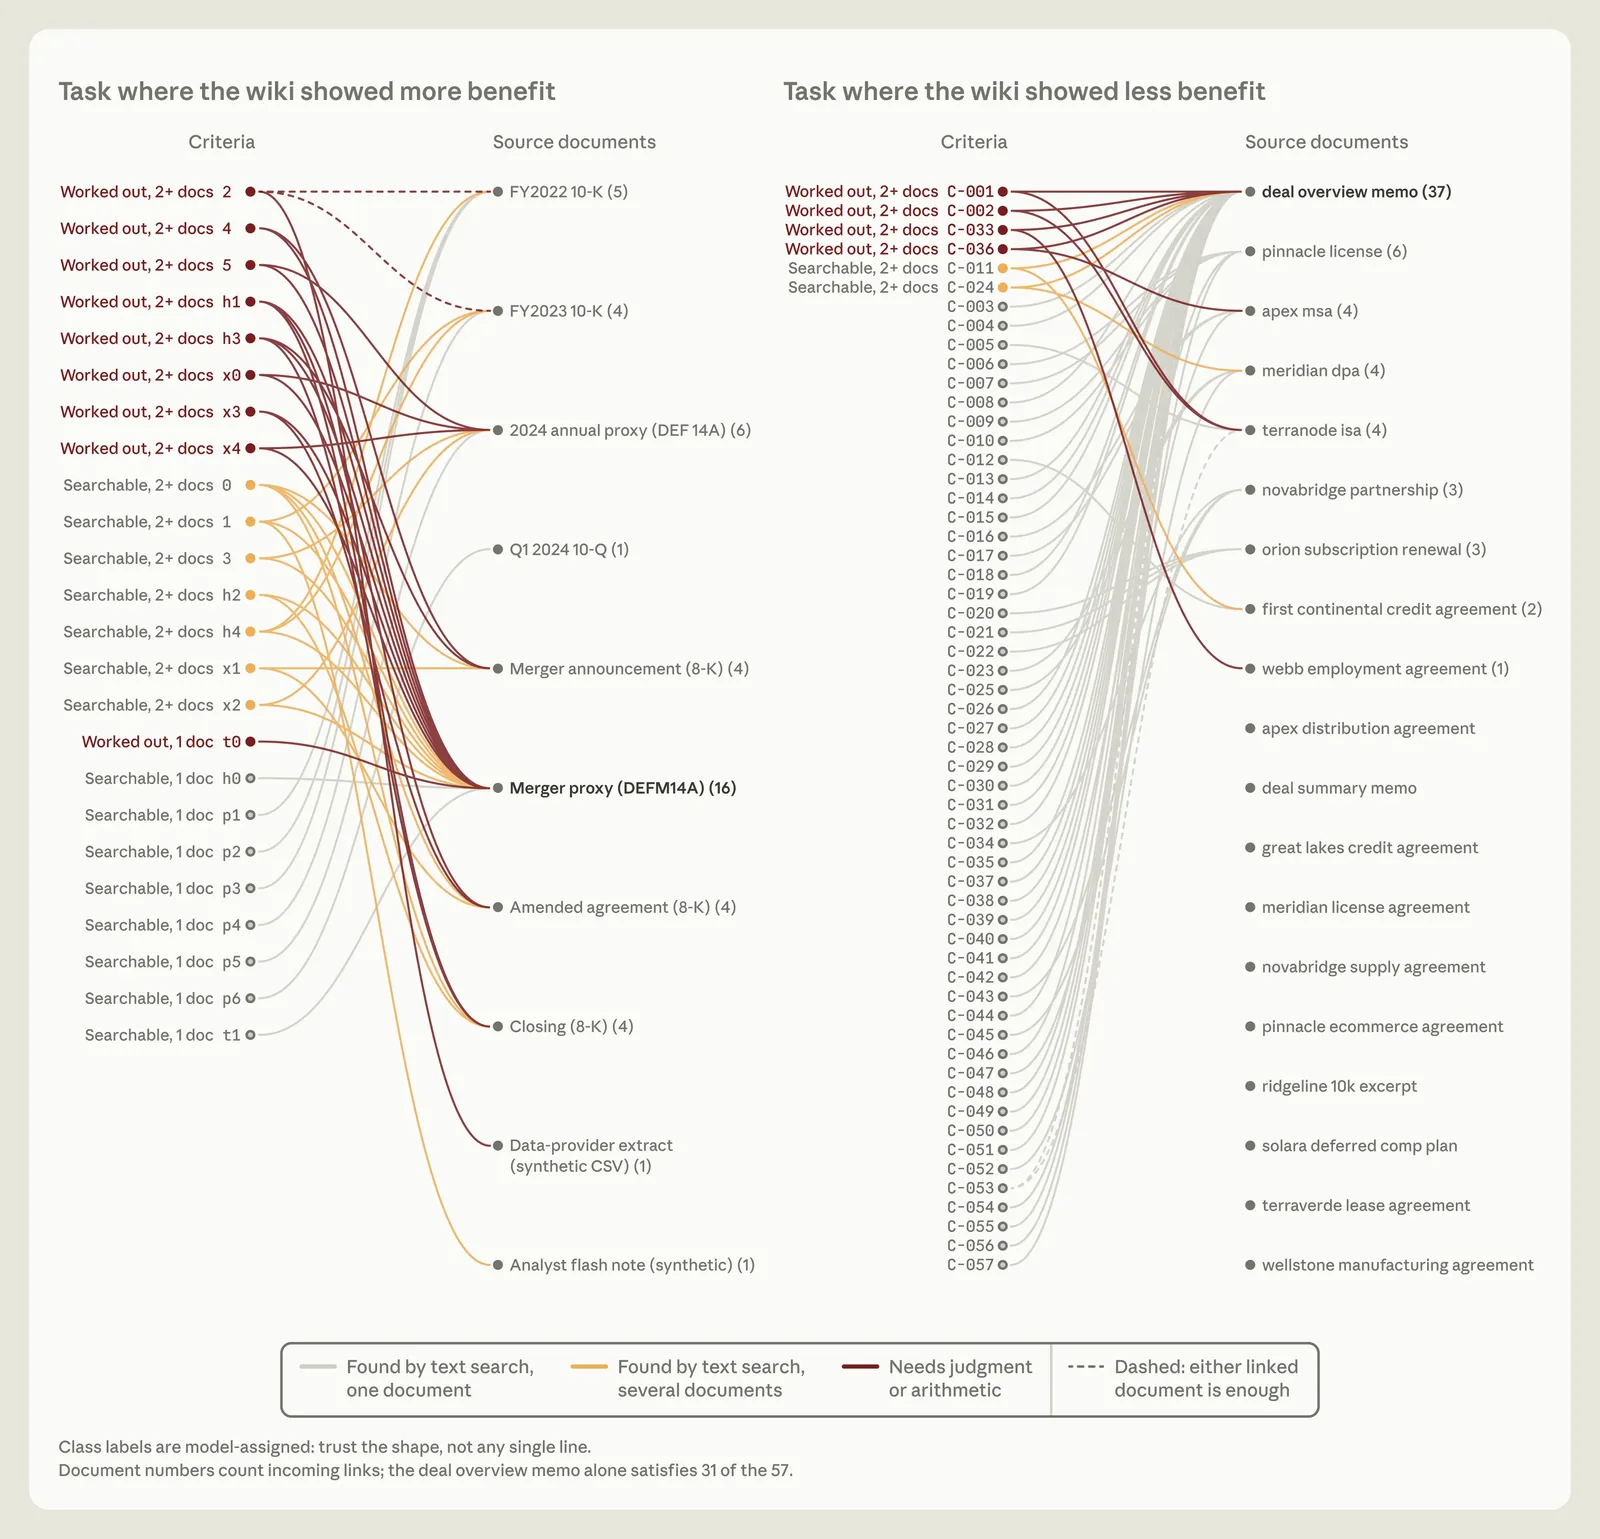
搜索与 wiki 的作用也不能混为一谈。同一实验中,同时使用搜索和 wiki 的综合分数随 wiki 扩充从 54% 升至 61%,仅使用搜索为 53%。另一项包含 24 个并购问题的测试中,需要跨文档综合、判断或计算的那组评分项,查 wiki 的得分为 87%,只搜索为 73%;但在能从单份文件直接检索答案的法律任务里,wiki 没有明显收益,有时还膨胀得比原始材料更大。
记忆的组织方式本身也会制造错误。一次合同实验中,多名智能体同时改写共享表格,关键信息因相互覆盖而丢失;改为每份合同由一个智能体独立建页、逐字引用条款后,信息保留情况改善。Anthropic 还提醒,错误笔记若被自动塞进每个新会话,会把错误持续带入后续工作,因此顶层记忆要保持精简,必要时结合原文搜索核验。
对构建长期助手、企业知识库或多智能体系统的团队,这篇文章提供的是可检验的设计经验:保留日志作为核对依据,让记忆可纠错,区分“搜索能找到”与“需要跨资料组织”的任务。Anthropic 仍把何时整理、如何持续更新和计算成本列为开放问题;文章描述研究与工程实践,没有宣布所有 Claude 产品都已开放统一的 dreaming 开关。
来源
- The components of agent memory — Anthropic