DeepSeek 开源生产推理框架 DeepInfer:首发支持 V4.1-Flash,可跑 NVIDIA SM100 与昇腾 950
DeepSeek 在 GitHub 以 Apache-2.0 许可开源 DeepInfer,称其为支撑自家大规模生产服务的推理框架;本次版本提供离线推理,首发支持 DeepSeek-V4.1-Flash,硬件覆盖 NVIDIA SM100 GPU 与华为昇腾 950 NPU,但不含 KV 缓存系统、预填充/解码分离与负载均衡等完整服务组件。
DeepSeek 在 GitHub 组织 deepseek-ai 下公开了 DeepInfer 仓库,README 称它是支撑 DeepSeek 大规模生产服务的高性能推理框架,此次开源版本提供离线推理及规模化服务所需的核心功能,许可为 Apache License 2.0。首个支持的模型为 DeepSeek-V4.1-Flash,默认检查点为 Hugging Face 上的 DeepSeek-V4.1-Flash-1017。
README 列出的功能包括优化内核与采样运行时(使用 FlashMLA、DeepGEMM、DeepEP 等自家库及 TileLang 内核)、注意力 DP 与 MoE 专家并行加负载均衡、带置信度调度验证的 DSpark 草稿解码、滑动窗口有界重放、异步调度、批次不变推理、确定性采样和结构化输出;其中批次不变与确定性采样仅限 NVIDIA。支持硬件为 NVIDIA SM100 GPU 与华为昇腾 950 NPU,需 Linux、Python 3.12,以及 CUDA 13 或 CANN 9.2。
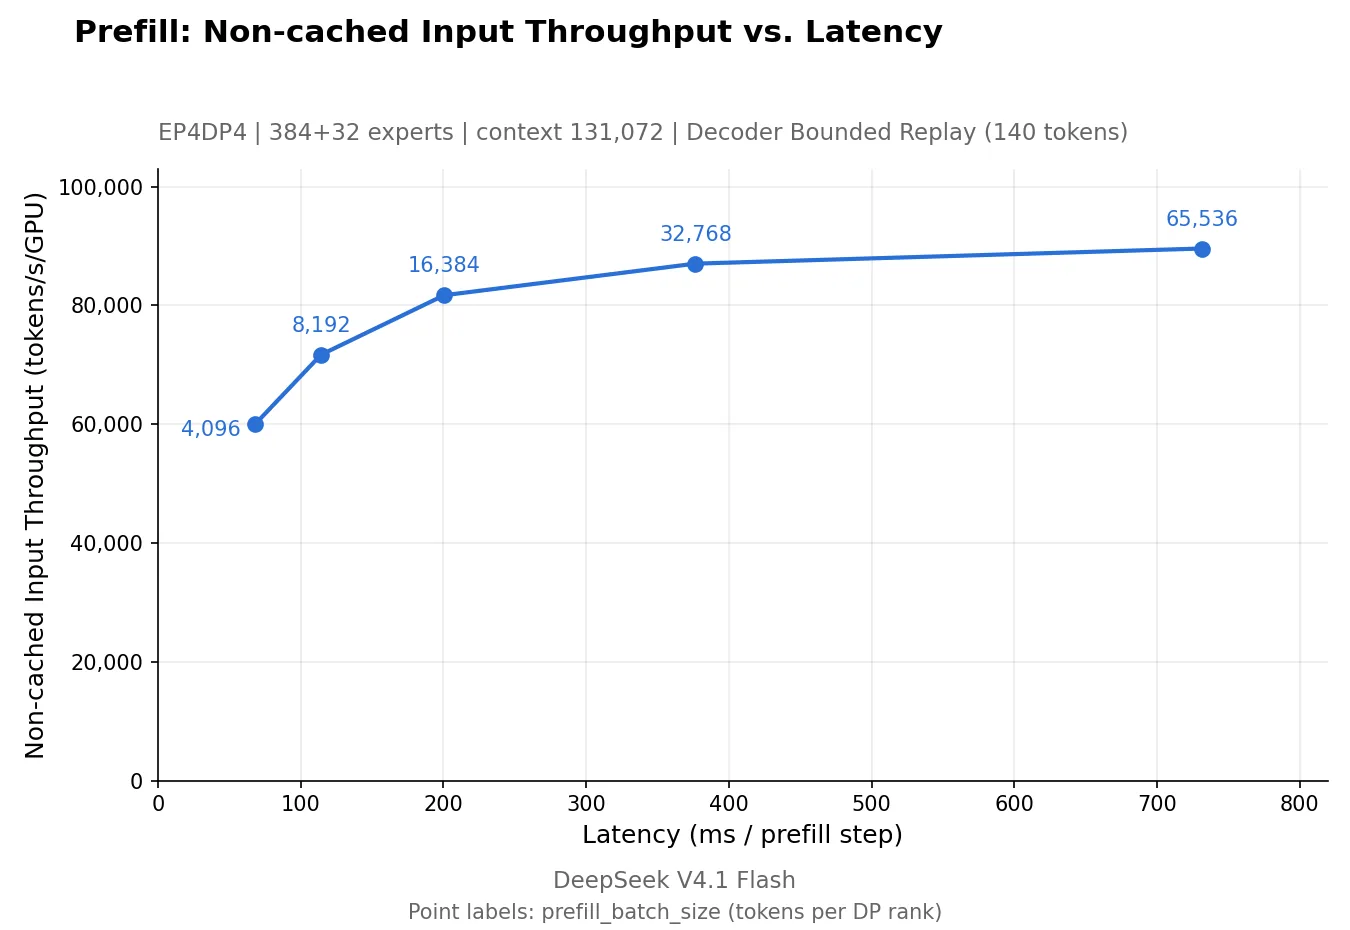
仓库明确写出,完整推理服务所需的 KV 缓存系统、视觉编码/预填充/解码分离以及数据并行副本间的负载均衡不在本次发布中,因此它目前更像可复用的引擎核心,而非开箱即用的在线服务。README 附有在 4 张 SM100 上测预填充、64 张上测解码的性能曲线,为厂商自测;项目致谢称最初主要基于 vLLM,并参考了 SGLang 与 TensorRT-LLM。
来源
- DeepInfer: High-performance, large-scale inference framework for DeepSeek models — DeepSeek-AI(GitHub)