Meta 详解 Prometheus:俄亥俄吉瓦级超算,目标约百万 GPU
Meta 工程博客介绍位于俄亥俄州 New Albany 的吉瓦级超算集群 Prometheus:一期已完成并用于训练 Muse 系列基础模型(含 Muse Wonder),现正继续扩容,目标规模约 100 万 GPU,并采用闭式液冷等效率技术。
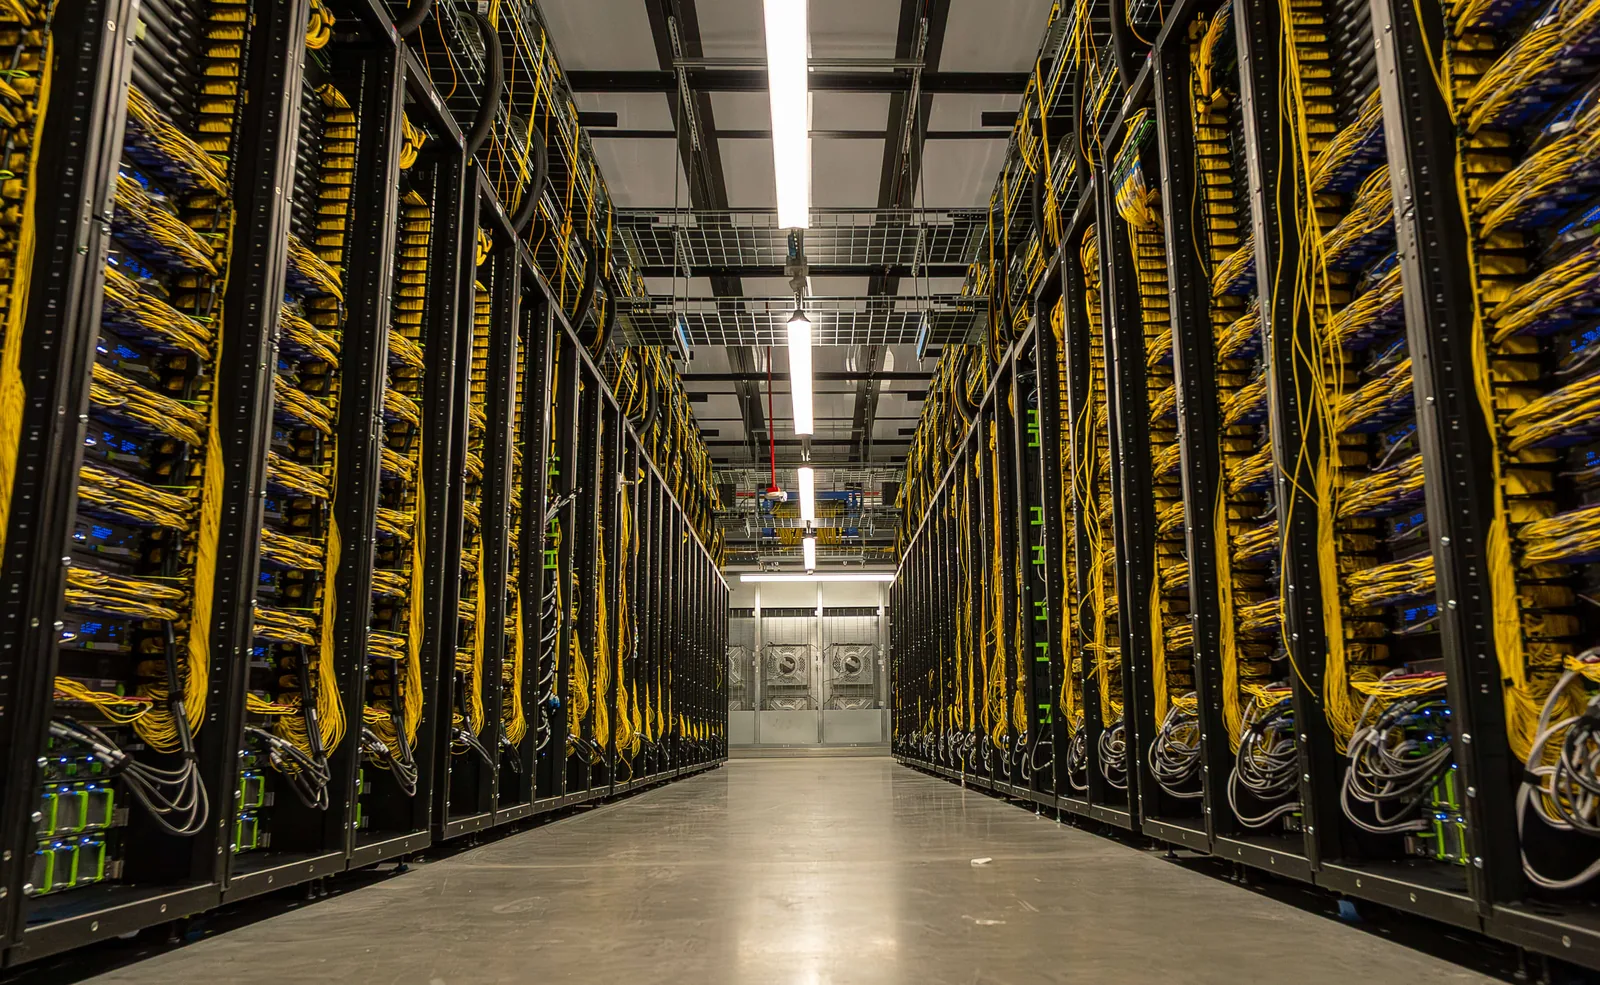
Engineering at Meta 发文称,Prometheus 是公司迄今最雄心勃勃的 AI 基础设施项目,建于俄亥俄州 New Albany:两年前该站仍以传统 Web 流量为主,现经硬件、网络与建筑改造后承载前沿模型训练。文中写明第一期已完成,并用于训练 Muse 基础模型家族,包括在个人与专业 agent 任务上表现突出的 Muse Wonder;当前集群由多栋互联建筑中的“数十万级”GPU 组成,全力规模目标约为 100 万分布式 GPU,并强调闭式液冷以提升运行效率。
稳定性方面,Meta 称 Muse Wonder 预训练 goodput 超过 85%、强化学习 goodput 超过 90%,训练期间 wall-clock MTBI 约 4.7 万 GPU 小时,随后固件等改进入后提升至逾 5.4 万 GPU 小时。硬件上现部署两代 NVIDIA 平台:Catalina(GB200 NVL72 Ariel 变体,双机架 72 GPU 域,每 GPU 800G 互联)与 Clemente(GB300 NVL72,单机架 72 GPU,HBM 至每卡 288 GB);第三代基于 NVIDIA Vera Rubin NVL72 即将到来。网络侧描述了楼内最多互联约 20,736 GPU 的以太网后端织物,以及跨楼 2 km 至逾 100 km 的 Backend Aggregation。文中数字均为 Meta 自述。
来源
- Inside Prometheus: Meta’s Journey to a Gigawatt-Scale Supercluster — Engineering at Meta