ElevenLabs 推出 Eleven v4 语音模型与低延迟 Turbo 版:更擅长情绪表达,支持 90 多种语言,已在 API 和自家产品开放
ElevenLabs 发布文本转语音模型 Eleven v4 及其低延迟版本 Eleven v4 Turbo,称新模型能按上下文理解语气、节奏与情绪,并可用自然语言和行内标签指挥演绎。两款模型支持 90 多种语言,现已在 ElevenAgents、ElevenCreative 与 ElevenAPI 中提供,可注册免费账号试用;公告未列出价格。
ElevenLabs 称,Eleven v4 基于全新架构,能根据文本判断应有的语气、节奏、人物性格与上下文,生成戏剧、温柔、急切、喜剧或日常对话等不同风格,同时保持说话人音色。用户可以用自然语言描述一句话该怎么说,也可以用 [laughs]、[light rain] 等行内标签指定情绪、口音和音效,公司称新模型比以往更准确地遵循这些标签;国际音标(IPA)发音支持也明显改进。多人对话中,模型理解整场语境,让说话人回应上一句,而不是拼接孤立台词。
Eleven v4 Turbo 面向语音智能体等低延迟场景:公司给出的中位推理延迟约 100 毫秒,从请求到听到语音的中位时间约 150 毫秒(2026 年 9 月以相同脚本和默认设置测得,已扣除网络延迟,经 WebSocket 流式传输),并与其智能体平台 ElevenAgents 一起优化。两款模型都支持 90 多种语言,用一种语言录制的声音可以带当地母语口音说其他语言;即时声音克隆只需 10 秒音频,v4 也支持更高保真的专业声音克隆(PVC)。
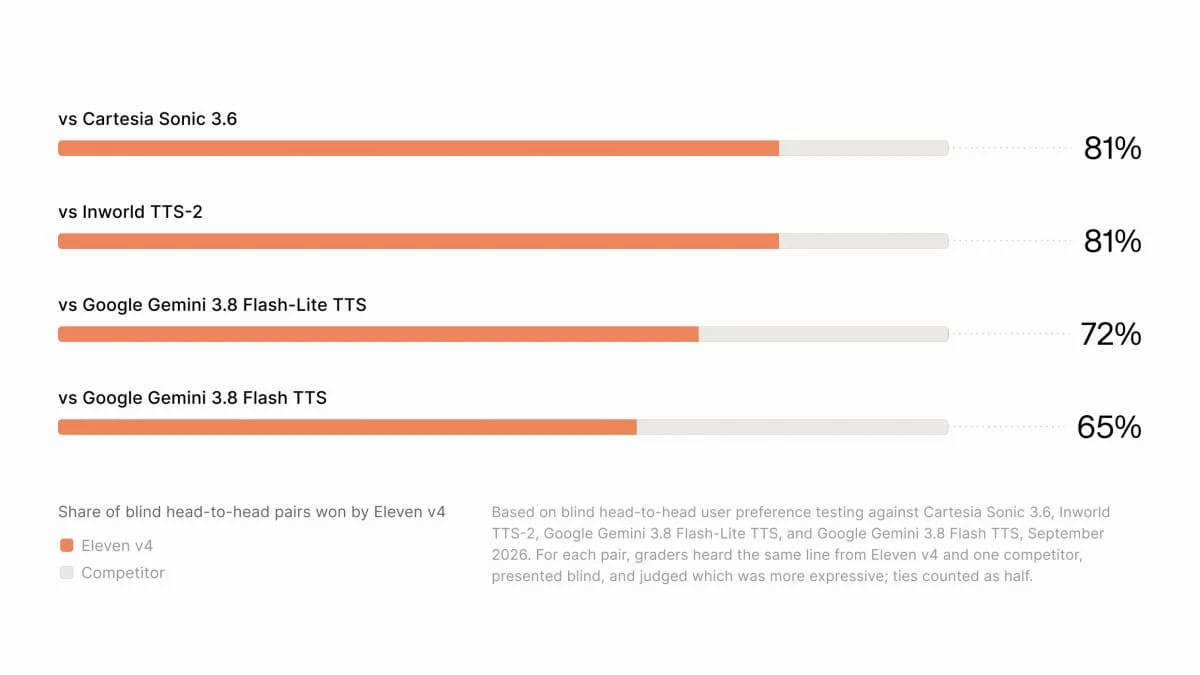
ElevenLabs 称,Eleven v4 在 Artificial Analysis 的语音竞技场排行榜(2026 年 9 月)排名第一;在公司组织的逐对盲测中,约 75% 的听众更偏好 Eleven v4,对比对象为 Cartesia Sonic 3.6、Inworld TTS-2、Google Gemini 3.8 Flash-Lite TTS 与 Gemini 3.8 Flash TTS,平局各计一半。以上排名、延迟与偏好数据均为厂商自报;公告未给出 v4 的价格或计费变化。
来源
- Introducing Eleven v4, our most emotive model — ElevenLabs:Blog(网页)