论文:固定模型下编程 harness 多花钱少提分,成本可差约 3×
山东大学 Yangze Liu、Zhongyi Han 的 arXiv:2610.04433 在 SWE-bench Verified 上固定模型比较 Claude Code、mini-SWE-agent 与 OpenCode:重型与轻型 harness 通过率约在 5 分内;OpenCode 可落后至约 9 分;换 harness 与同配置重跑的任务翻转率均约 13%;同价目下每任务成本可差至约 3×,主因每步重发的前缀 token。
论文《What Does a Harness Buy? Tokens, Mostly.》(arXiv:2610.04433,作者 Yangze Liu、通讯作者 Zhongyi Han,山东大学;arXiv v1 标注 2026-10-03 提交)把「编程智能体」拆成固定底层模型 + harness(系统提示、工具集与上下文管理)。作者在 SWE-bench Verified 上把五款模型跑过 Claude Code、mini-SWE-agent、OpenCode 三种现成 harness,并做同配置重跑以估计噪声。结论写在标题里:买到的主要是 token 账单,而不是稳定更高的通过率。
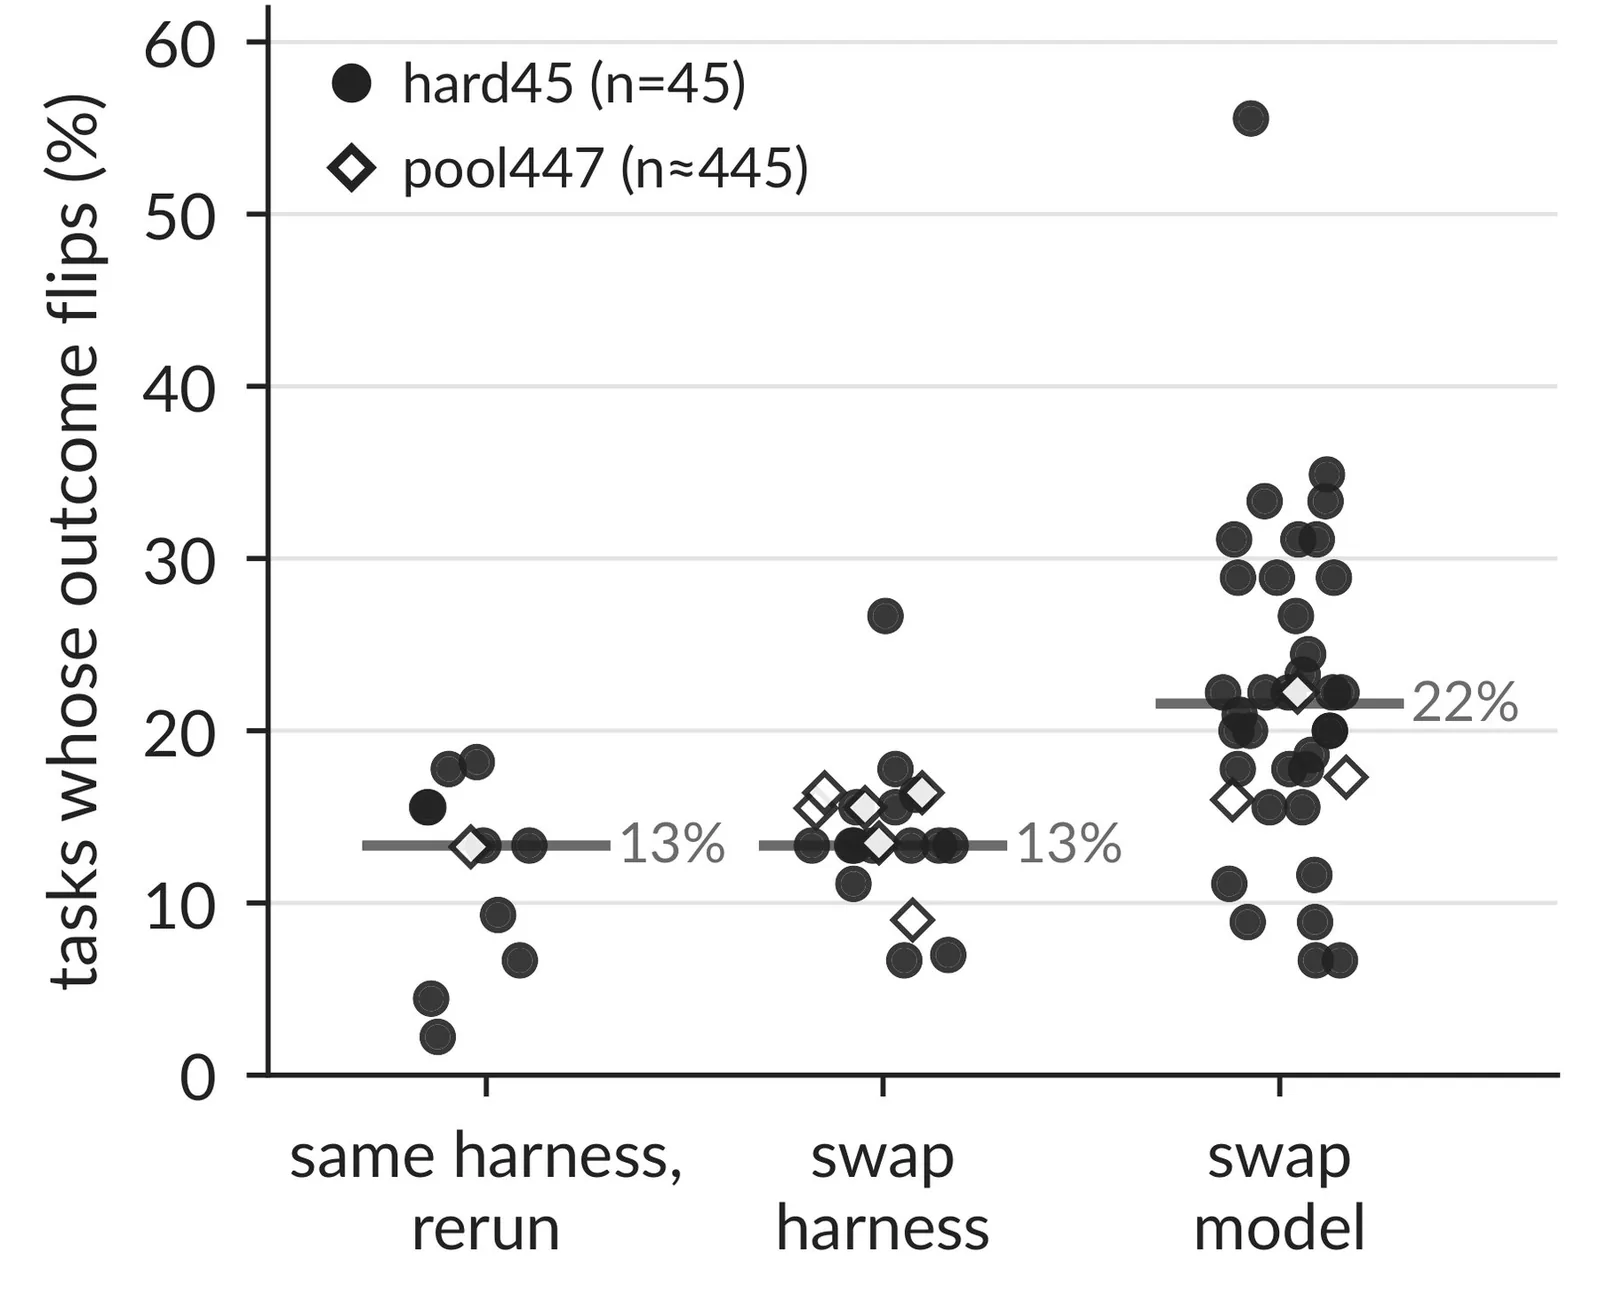
在作者跑满的约 447 任务池、两款模型上,最重的 Claude Code 与最轻的 mini-SWE-agent 通过率落在约 5 个百分点以内,作者称为等价。可清晰跨过噪声的 harness 效应是损失而非增益:OpenCode 在大池上可落后最多约 9 分;在某一模型上,约一半差距来自输出长度上限截断——Claude Code 会提示继续,OpenCode 则常让该步结束。在 45 题困难子集与五模型上,换 harness 翻转的任务比例中位数约 13%,与「同一 harness 再跑一次」相当;换模型则约 22%。作者强调:某次跑赢的题,下次未必还是同一批。
成本侧,同一模型、同一任务集、同一价目表下,每任务费用可差至约 3 倍。差距主要来自每一步都会重发的 system prompt 与工具 schema 前缀,并随步数放大;逐步上下文增长与单次工具输出差异较小。Decoder 2026-10-24 的跟进报道复述上述数字,并指出许多宣传中的数个百分点「提升」可能落在重跑噪声与统计分辨力之下。作者建议任何 harness 对比都公布同配置重跑。数字均取自论文/报道原文,不作外推。