ElevenLabs 发布 Eleven Realtime:面向实时对话的两款语音到语音模型
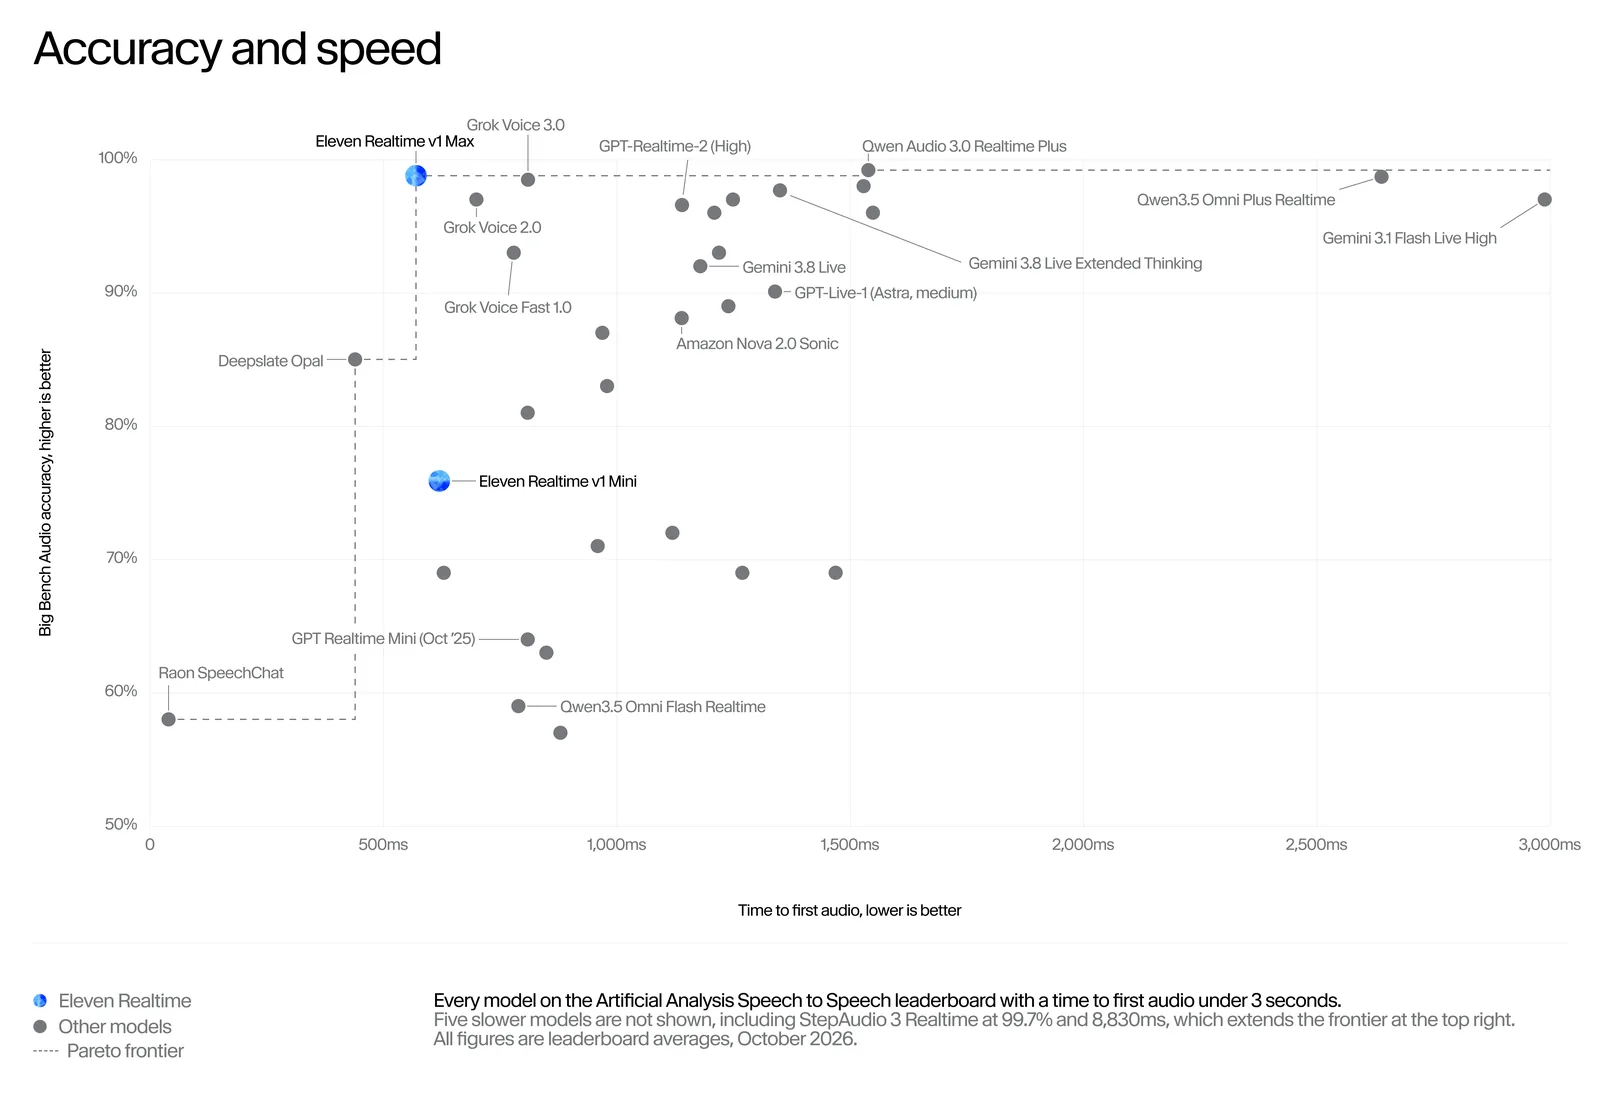
ElevenLabs 推出完整语音智能体模型 Eleven Realtime v1 Mini 与 v1 Max,支持 90+ 语言与库内 17000+ 音色;官方援引 Artificial Analysis:Max 在 Big Bench Audio 正确率 98.8%、首音约 0.57 秒。
ElevenLabs 在官方博文宣布推出 Eleven Realtime——一类语音到语音(Speech to Speech)模型,每个模型即完整语音智能体,无需自拼 ASR、VAD、轮次、LLM 与 TTS。即日发布两款:v1 Mini 面向低成本自然对话(助手、教师、互动角色等多数场景);v1 Max 面向需跟流程与多步推理的复杂任务(客服、线索筛选等)。两者均支持 90 种以上语言,并可使用 ElevenLabs 库中 17000+ 音色。
公司援引 Artificial Analysis 独立评测:Big Bench Audio(1000 道语音推理题)上 v1 Max 正确率 98.8%、v1 Mini 75.9%;平均开始说话时间 Max 0.57 秒、Mini 0.62 秒。Full-Duplex-Bench(停顿、轮次、打断等)上 Mini 95.8%、Max 94.1%。Speech Agent Arena 盲测对比得分 Max 998、Mini 988;工具调用任务完成率 Max 87.1%、Mini 60.3%,故官方建议重工具场景用 Max。入口上,可在 ElevenAgents 下拉选择 Realtime 模型;Realtime API 经 WebSocket 且称兼容 OpenAI Realtime 规范,迁移时改 endpoint 与模型名即可。数字为厂商援引第三方榜单,非本站复测。