百度开源文心 5.5 Flash Base:2800 亿参数 MoE 基座,不含后训练,FP8 与 BF16 权重已上线 Hugging Face
百度 11 月 5 日开源文心 5.5 Flash Base(ERNIE-5.5-Flash-Base),总参数 2800 亿、每个 token 激活 140 亿的混合专家模型。它是预训练结束时的基座检查点,没有做微调或后训练,权重已在 Hugging Face 提供 FP8 和 BF16 两个版本。
据模型卡,该模型用 33.5 万亿 token 预训练,训练上下文最高 128K,微调和推理阶段支持最长 100 万 token。百度说它刻意在预训练结束时就放出权重,作为领域适配、指令微调和强化学习研究的共同起点;The Decoder 指出,后训练版本预计随后推出,因此眼下的模型并不能直接当聊天或代理模型用。
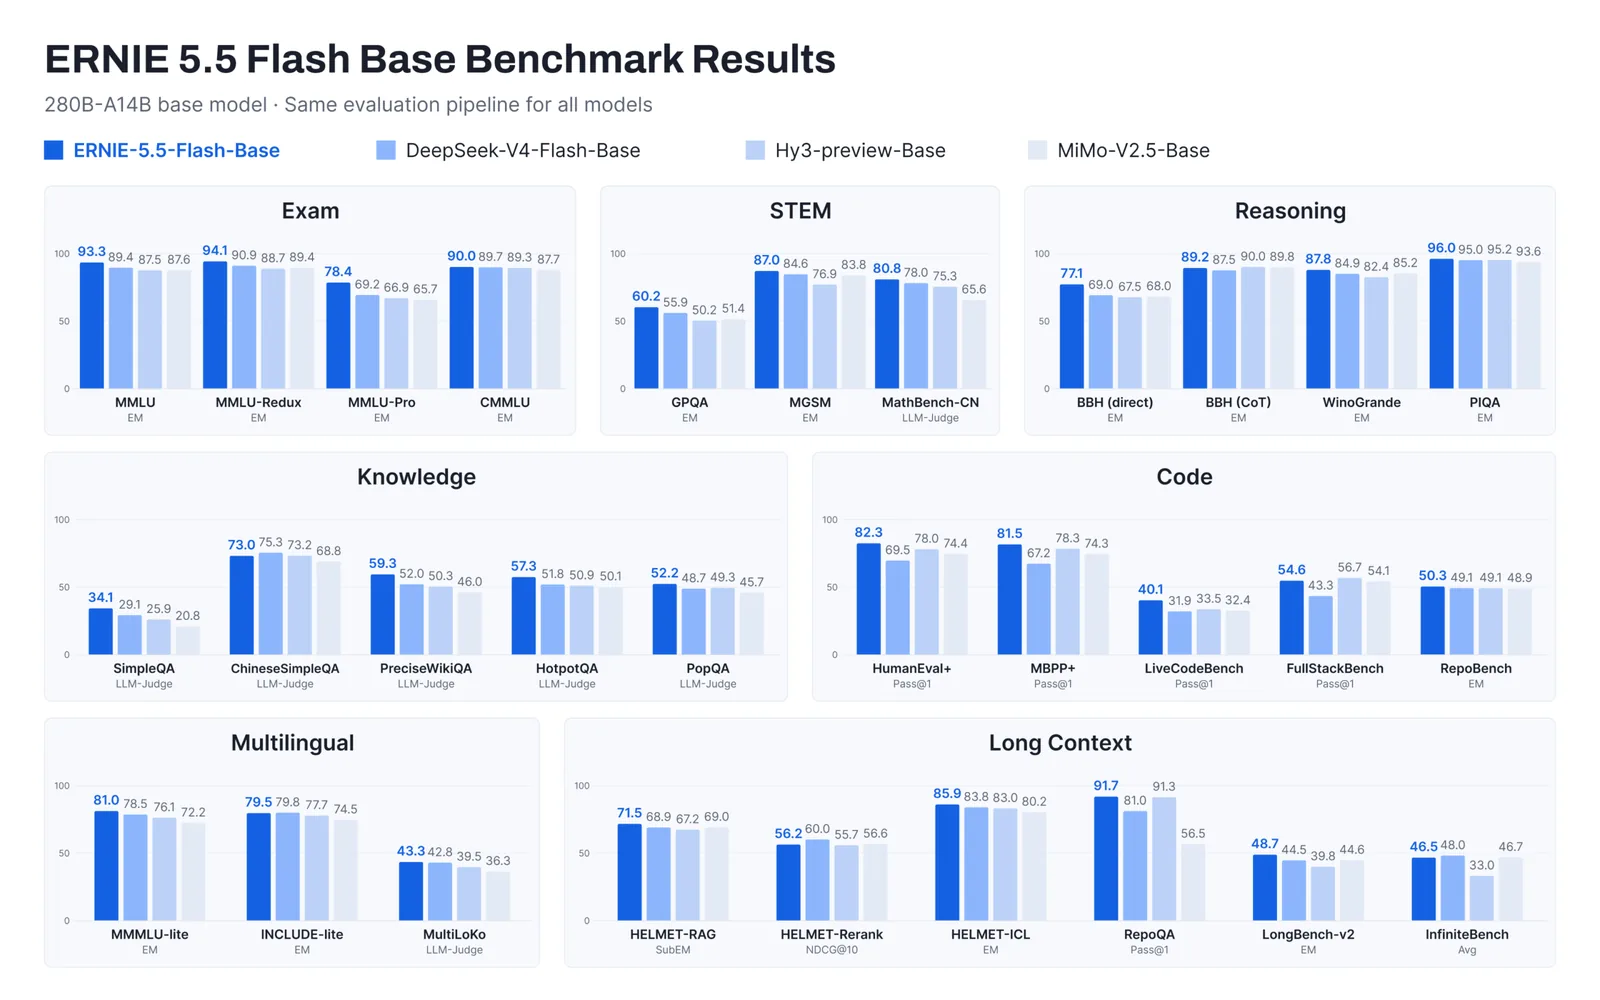
在同一评测流水线下,百度把它与 DeepSeek-V4-Flash-Base、Hy3-preview-Base 和 MiMo-V2.5-Base 对比,称在知识、推理、数学、代码、多语言和长上下文基准上取得同尺寸模型 SOTA(最好成绩)。这些对比由百度自己完成;基座模型的分数也不等于最终产品表现。
百度的量子位转载稿称,这一代以“效率”为主线,改动了注意力机制(Latent-Gated Sparse Attention)、专家路由(Multi-Router Latent MoE)和训练目标(ECHO),目的是降低长上下文的显存和计算开销。授权方面,模型卡写明适用《ERNIE 5.5 Flash Base 模型许可协议 v1.0》,商用条件需阅读该协议。
来源
- baidu/ERNIE-5.5-Flash-Base — Hugging Face(百度模型卡)
- 百度开源文心5.5 Flash Base,多基准测试刷新同尺寸模型 SOTA — 量子位(百度提供、授权转载)
- Baidu releases ERNIE 5.5 Flash Base with 280 billion parameters as an open-source foundation model — The Decoder