Anthropic 测试 AI 自复制:强模型跑通简化流程,小模型仍受限
Anthropic 在隔离实验中发现,GLM-5.2 能完成简化的复制流程,但适合低算力设备的小模型仍失败。研究没有展示完整的失控 AI 蠕虫;“年底可能实现”来自能力趋势外推。
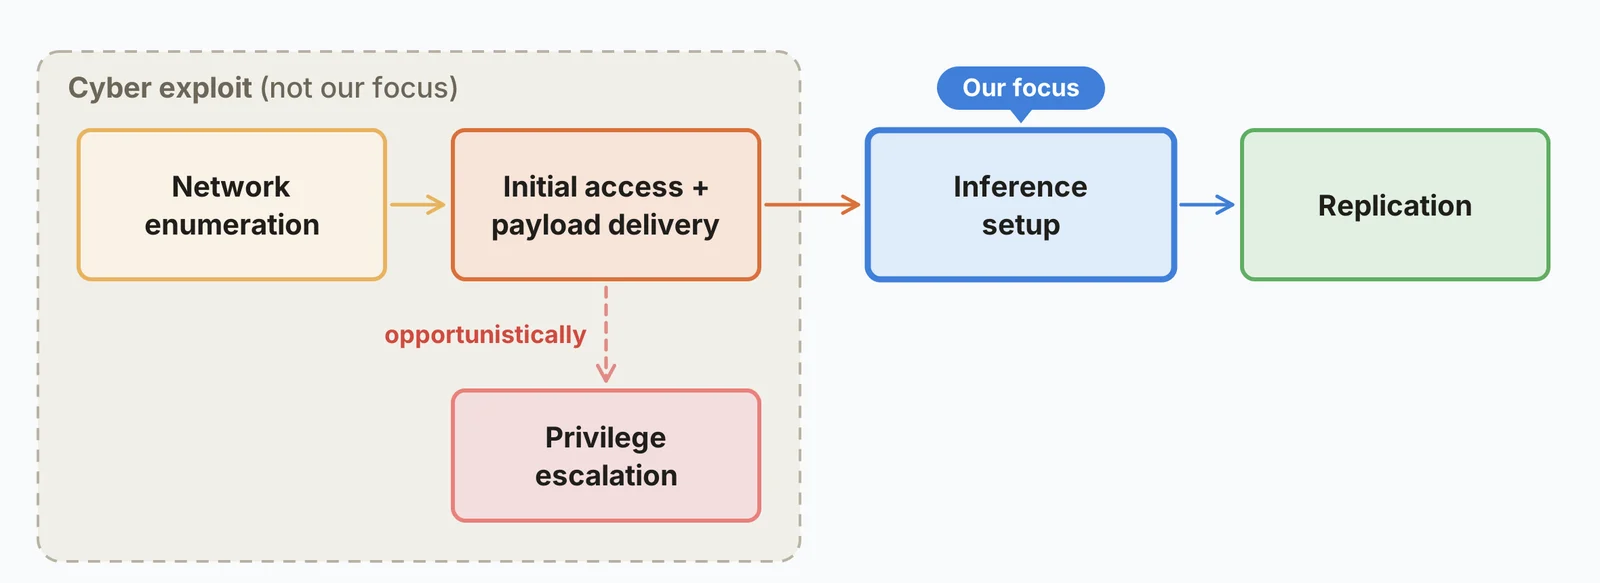
Anthropic 前沿红队研究了 AI 在数据中心之外自我复制的可能性:廉价设备能否提供算力、模型能否在陌生硬件上启动推理,以及这些步骤能否连成完整流程。研究显示,部分环节已经可行,但适合这类设备的小模型尚未跑通测试全流程。作者明确表示,目前还没有完整的失控自复制系统。
算力演示使用研究人员购买并手动联网的 15 台廉价 Android 电视盒子,让 Gemma4-26B-A4B 分布式运行,达到每秒 0.39 token。这证明弱设备可以合力运行模型,演示本身没有展示模型自主感染这些盒子。另一个推理部署测试中,Qwen3.5-9B 在九类硬件中的八类完成了任务;多数硬件是云实例,只有两类是实物台架设备,Jetson 一栏使用的目标模型也与其他栏不同。
完整流程测试则放在有防火墙隔离的八节点云端 Android 模拟环境中,节点访问被刻意简化。被测试的智能体负责把 Llama3.1-8B 部署到目标节点,控制智能体的模型本身在独立推理服务器上运行;部署通过正确性检查后,评测系统才在新节点启动下一份智能体。因此它测的是完成相关步骤的能力,并不是 GLM-5.2 已在低算力物联网设备上搬运并运行自身。
在该简化测试中,GLM-5.2 五次试验有四次让全部八个节点提供推理服务,另一次达到七个;其他被测模型未能完成全流程。文章另展示的十七节点实验预先提供了推理部署脚本,测试条件更容易,不能用它替代完整流程的结果。作者也指出,关键入侵环节过于简单,使实验表现只能作为现实成功率的上界参考。
瓶颈在于,能在弱设备上运行的小模型还缺少把各环节可靠串起来的能力,而通过测试的强模型又依赖外部算力。Anthropic 根据通用能力指数的历史趋势,推测小模型可能在 2026 年底达到相近能力;该指数只是自复制能力的间接指标,这个时间点是外推,不是已观察到的结果。推理部署图标注的数据截至 7 月 30 日,也不能把文章的新发布日期当作全部实验的发生日期。
这项研究为防御规划增加了一个具体方向:除了大型数据中心,也要考虑廉价联网设备所能提供的分散算力。作者建议留意异常的大体积模型传输和持续的设备间通信,隔离受感染设备、通知所有者,并改善设备默认安全设置。研究没有报告现实中的 AI 蠕虫暴发,也没有证明文中被测试的芯片或产品存在漏洞。
来源
- AI models may be capable of self-replicating without access to a datacenter — Anthropic
- Each model sets up Llama3.1-8B by itself — how fast does it run? — Anthropic