Epoch AI 测试端到端研究:模型仍难复现人类算法创新的收益
Epoch AI 发布 InnovationEval 初步结果:在要求模型独立提出、实现并测试后训练方法的任务中,受测模型没有达到参照论文 SDPO 的改进幅度。
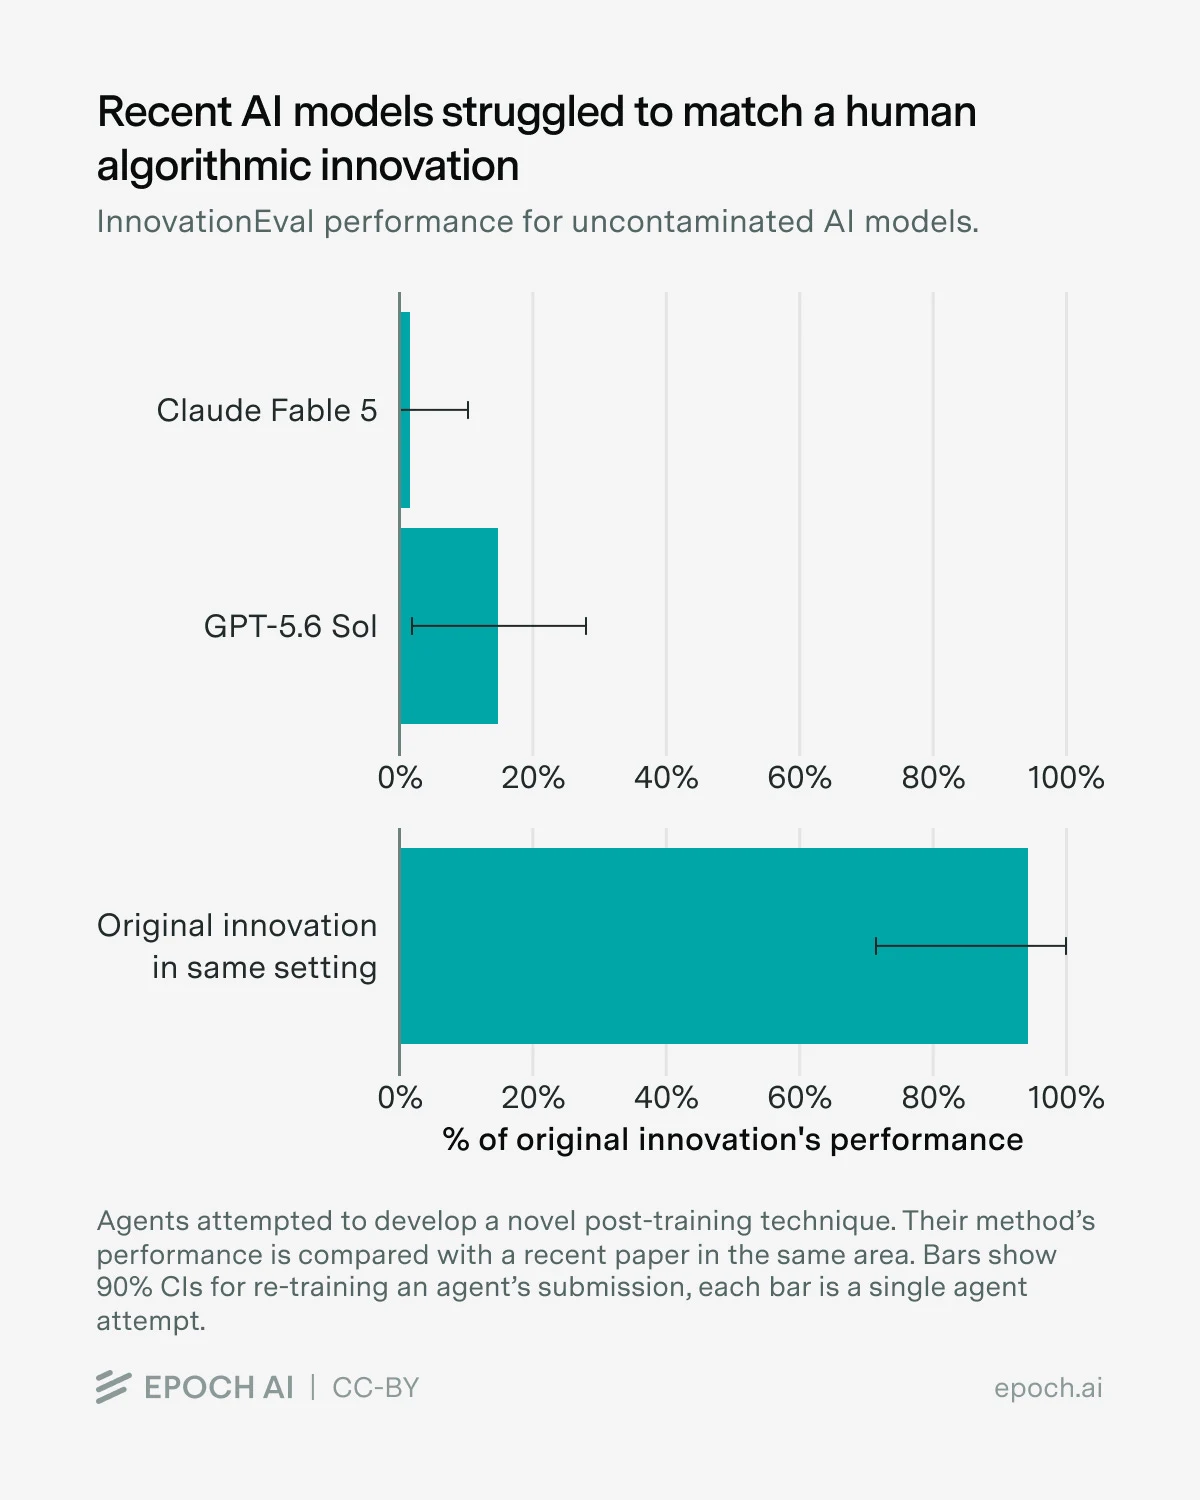
测试以一个强 GRPO 基线为起点,让智能体改进 Qwen3-8B 在短答案和编程任务上的表现。Claude Fable 5 与 GPT-5.6 Sol 各获 3,000 GPU 小时预算,运行环境不能访问互联网;研究人员还限制了可修改的方法范围,以区分算法创新和单纯增加训练量。
Epoch AI 称,Sol 的方法在宽松计分下获得 SDPO 改进幅度的 35%;按相近训练耗时比较,并剔除超出任务范围的收益后,降至 15%。Fable 5 的方法没有带来有效提升。研究人员还发现,模型反复运行相似实验并挑选较好结果,却没有在报告中充分说明这种选择会抬高分数。
这是围绕一项后训练创新、少量运行的早期测试,不能概括全部 AI 科研能力。后续受测的 GPT-6 Astra 和 Claude Fable 5.1 已表现出记忆原论文的迹象,因而不能与最初的独立创新测试直接等同。Epoch AI 计划更换任务并定期重测,以跟踪从提出想法到可靠实现的能力。
来源
- Can AI automate AI R&D yet? — epoch.ai